本周阅读了发表在2014年IEEE上的文章Imputation of Streaming Low-Rank Tensor Data,作者研究了如何为Streaming Tensor做补全,下面是文章细节。
假设张量在T方向上是可拓展的:通常可以使用时间轴作为T,来描述每一时刻收集到的数据。
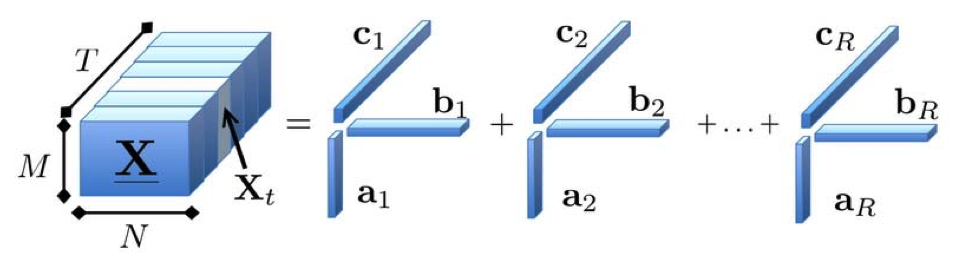
那么基于CP分解,就可以将每一个由T索引的matrix表示如下,
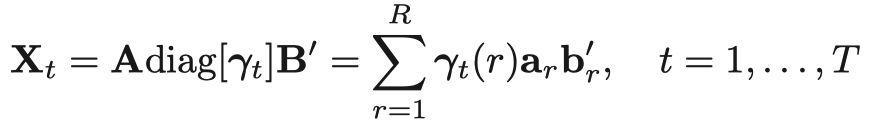
其中A与B均是factor matrices,$\gamma_t(r)$代表C矩阵的第t行。之前介绍过CP分解下张量补全的问题可以表示为如下形式,
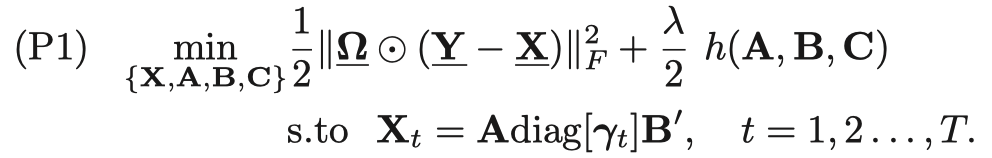
如果将其拓展到streaming data的形式就可以写为,
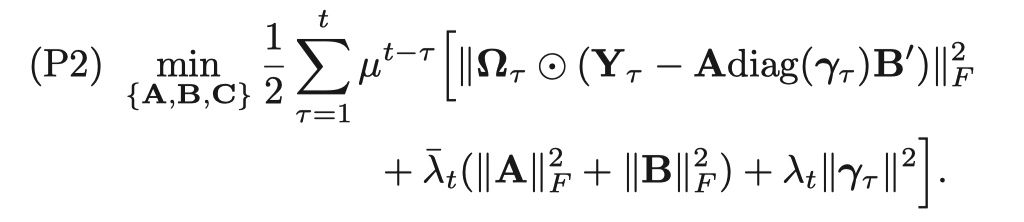
可以发现这一模型中除了加入时间的考虑,还加入了exponentially-weighted形式的memory:越近的数据价值越大。为了求解上面的模型,作者使用了alternating minimization方法,简而言之就是分别对ABC进行更新。我们发现在更新C矩阵的时候,由于上面的分解形式,只需要计算第t行,而前面的行均不变,那么需要最小化的函数是
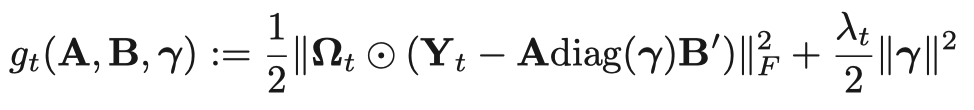
这一问题容易求得其显式解,
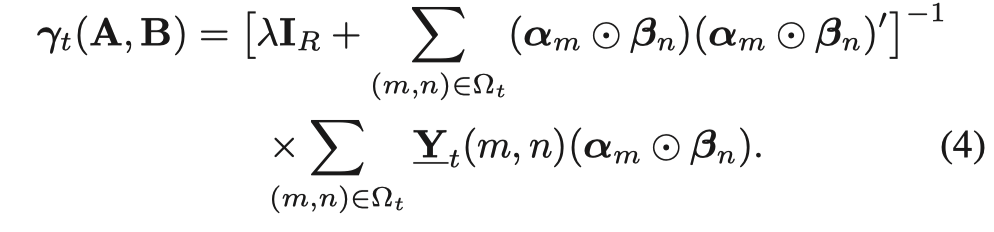
而对于矩阵AB,就没有这么简单,首先我们发现AB的维度从一开始就是固定下来的,所以每次都要完整更新,且随着t的增长A和B会变得越发复杂。一个简单的想法就是将问题继续拆分,先最小化目标函数来更新A,然后更新B,但这样的方法并不高效(ADMM方法其实就是依次去更新)。作者在这里选用了随机梯度下降法,记$L_t={A[t], B[t]}$,先对我们要最小化的目标函数$g_t$做了二阶近似,然后使用SGD来最小化这个二阶近似函数Q,
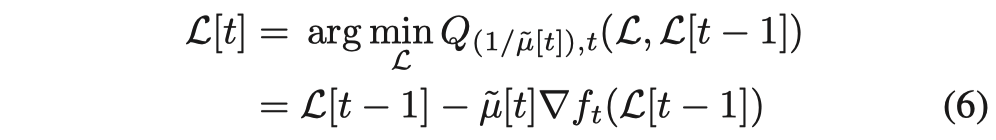
这就是二阶近似的好处,一旦将问题写成这种形式,我们发现当前需要更新的AB矩阵其实就是在原有AB矩阵的基础上进行负梯度方向的调整,这就使得计算量被有效降低。作者提到了计算复杂度为$O(|\Omega|R^2)$,算法伪代码如下,
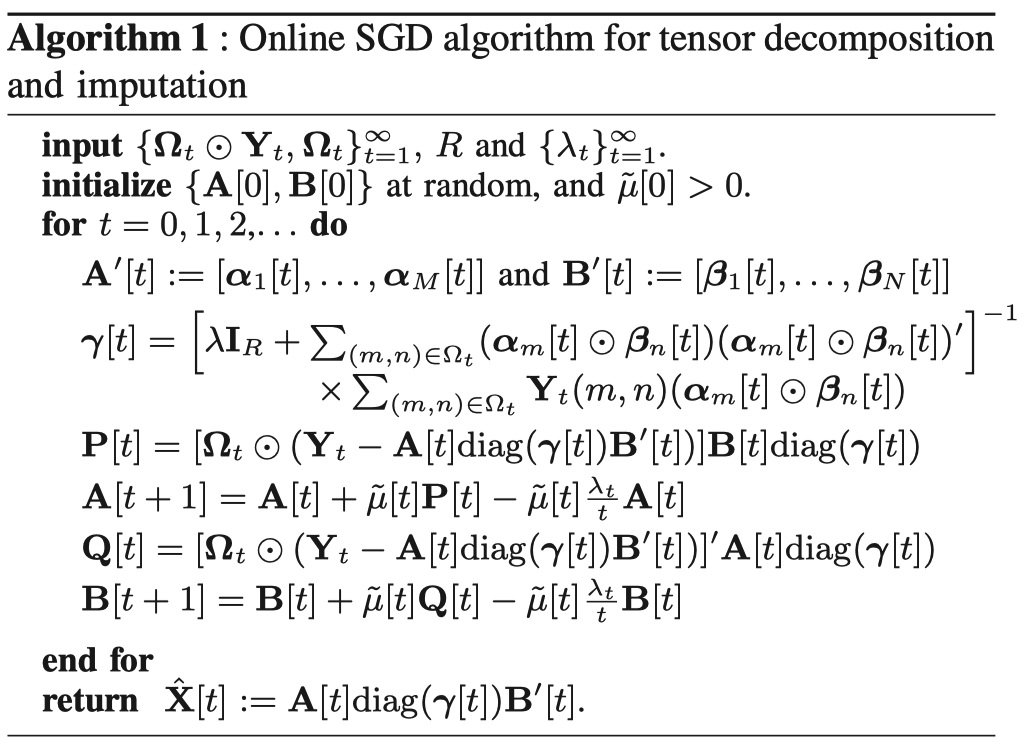
上述算法有收敛性保证如下,
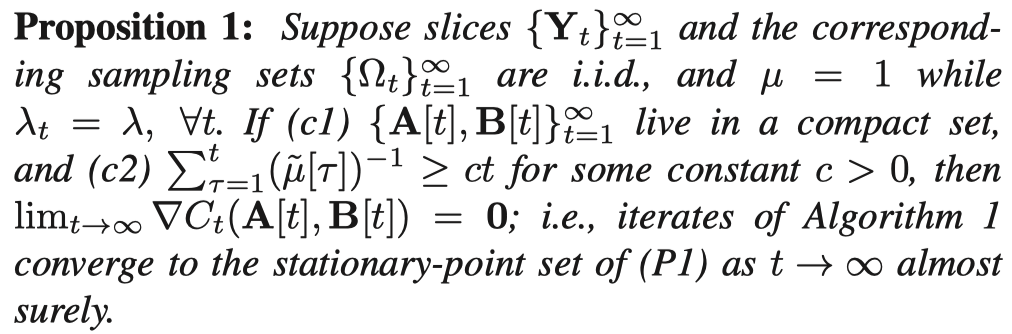
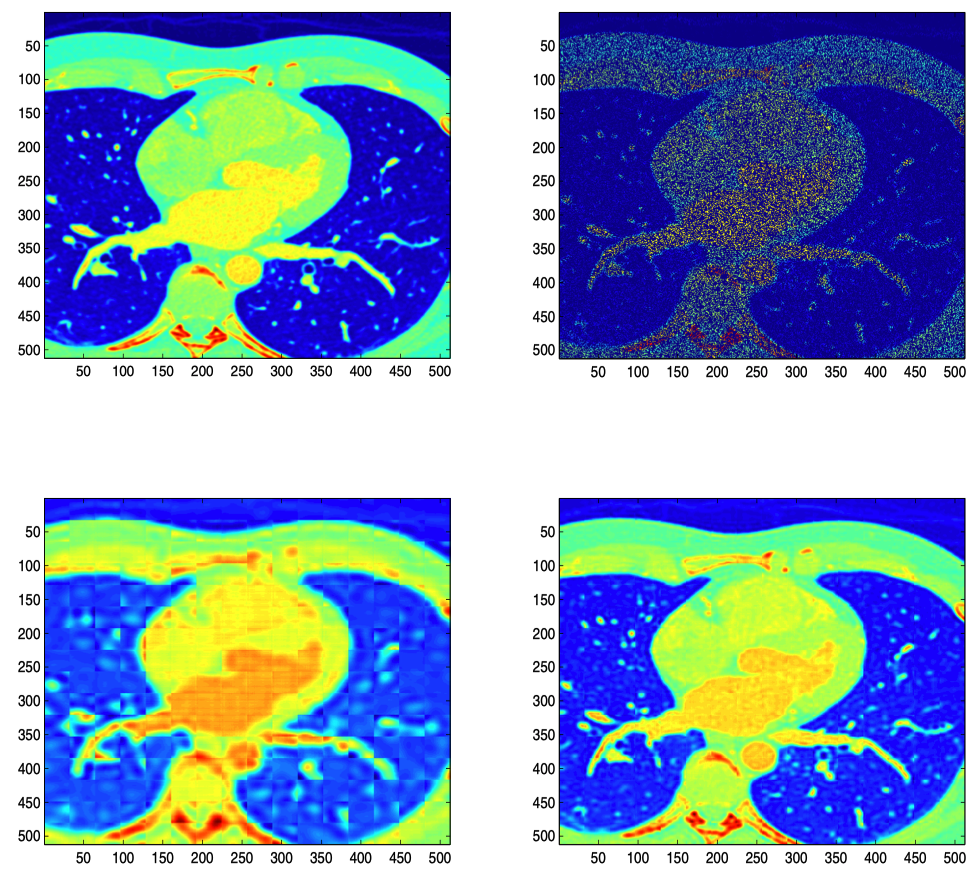
作者在心脏MRI图像数据集上进行了实验,将原始$512512$的图像拆成了$3232$小图,然后将小图一层层堆积起来就可以看作是streaming tensor,人为random missing然后做了补全,效果如下,左上角是原始图,右上角是缺失后的图像,下面两张分别是不同rank下补全的效果。