本周阅读了Tensor Completion Algorithms in Big Data Analytics这篇论文,对低秩张量补全问题做了较为全面的概括。
这一问题最原始的定义为
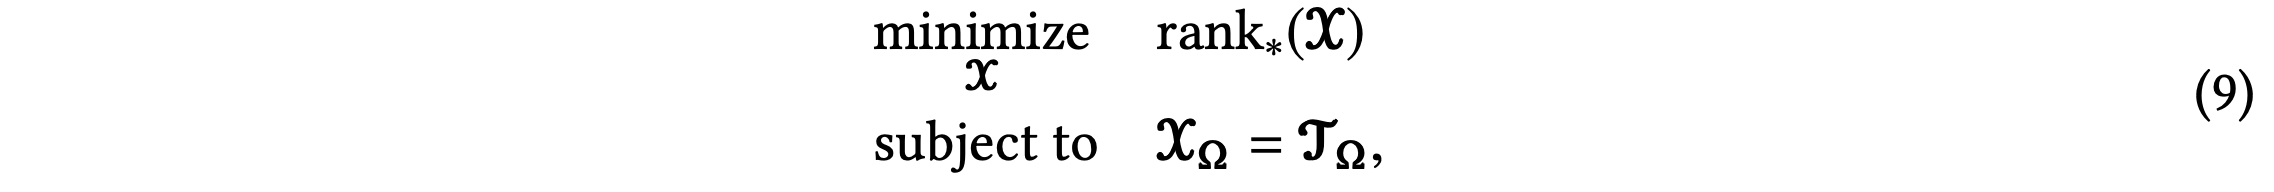
由此便衍生出了三类基本算法,第一类是基于张量Decomposition的。拿CP分解为例,如果张量可以用以下factor matrix的外积来表示,
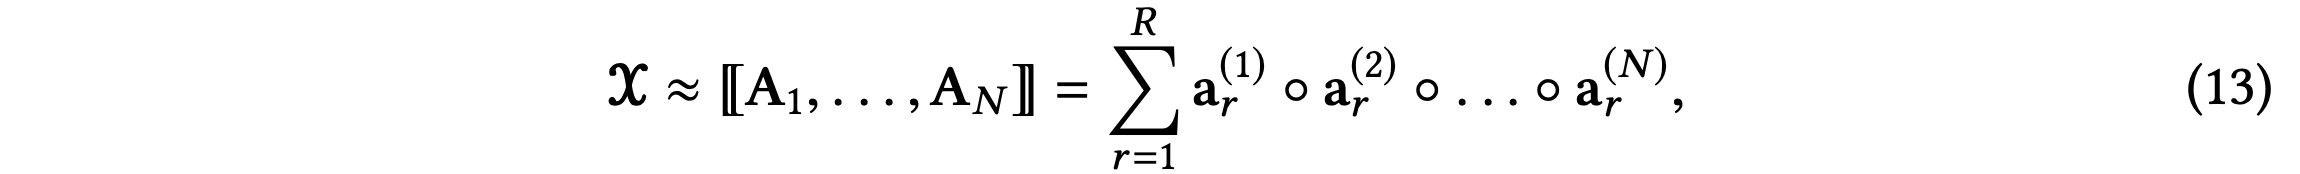
那么就可以用EM-like Approach和Missing-Skipping approach两种方法来进行张量补全。前者使用如下方式更新,
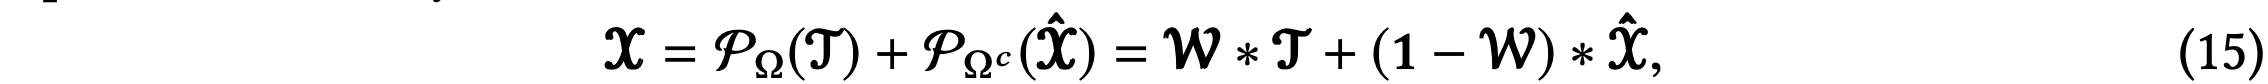
每一轮更新后的X继续用于下一轮的张量分解,直到算法收敛,所以称为EM-like。经典的算法有CP-ALS,其缺点也很明显,随着缺失数据比例的增长精度会大幅下降且容易收敛到局部最优。后者只利用观测数据的信息,并不在每一轮对X进行更新,其目标函数可以写成
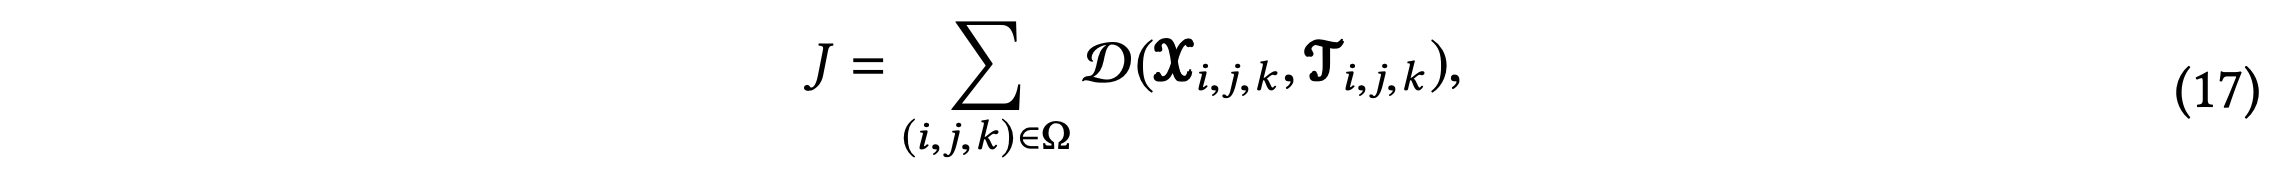
其中最常用的D函数就是likelihood,这一方法在missing ratio较高时更加稳健,但因为只对观测值进行考量,更难以优化。Tucker分解也对应了这样的两类补全方法。这两种分解方式有各自的优点:(1) 如果仅在乎补全准确性而不是解释性,那么Tucker分解更加合适。(2) CP分解的优点在于因为只有因子矩阵,所以解释性更强,容易加入辅助信息来进行提升,且因为没有引入core tensor,所有运算都是矩阵层面的,更容易拓展到large scale的情形。
第二类算法则是基于Trace norm,将原始的LRTC问题简化为了,
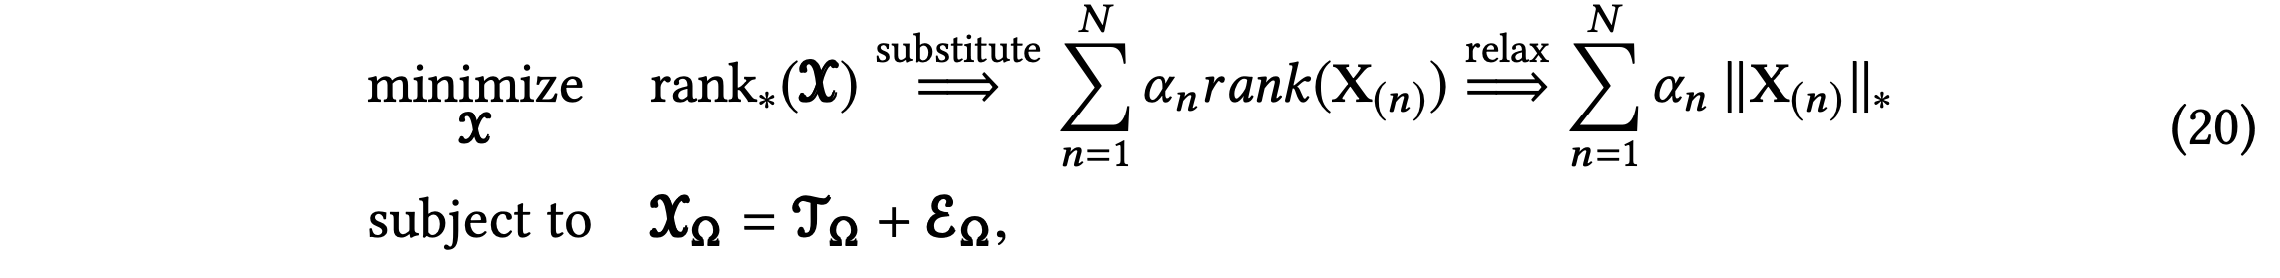
这一方法的优势在于将rank转化为了trace norm,所以不用再预先指定rank,一个经典的算法FaLRTC就是研究了如下问题,
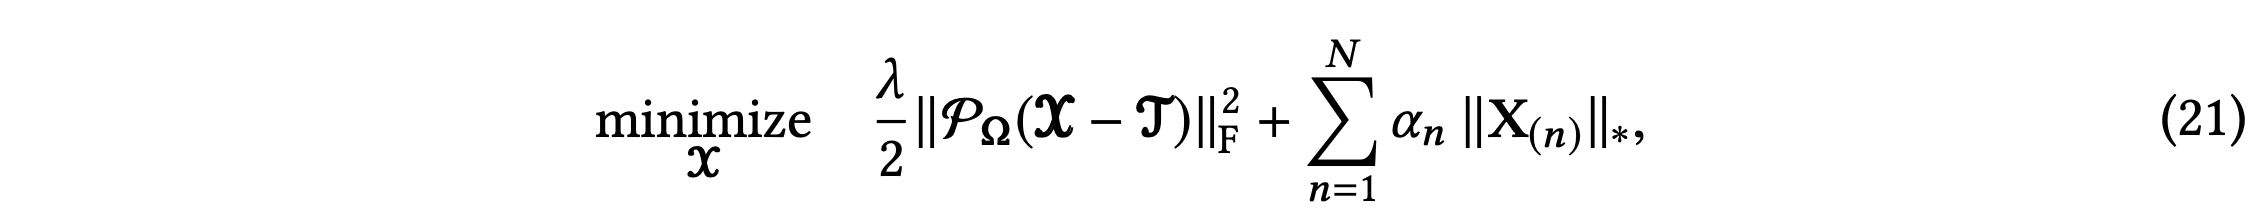
作者分别使用ADMM和block coordinate descent来解决了这一问题。
第三类算法则是基于Riemannian优化,算法分为两步,第一步是构造Tucker流形和tangent space且用梯度法对目标函数进行更新,第二步称为retraction map,将更新好的张量映射到低秩张量流形上。
基于这三类基本算法,研究者进一步提出了结合辅助信息的张量补全算法,主要分为两大类,第一类通过构造张量每个维度的相似性矩阵来引入惩罚项以提升补全准确率。第二类算法的想法则是引入一个Y矩阵,这一矩阵与原始张量在某个方向上是共享latent factors,那么就可以通过一起分解来提升准确率,具体问题定义如下,
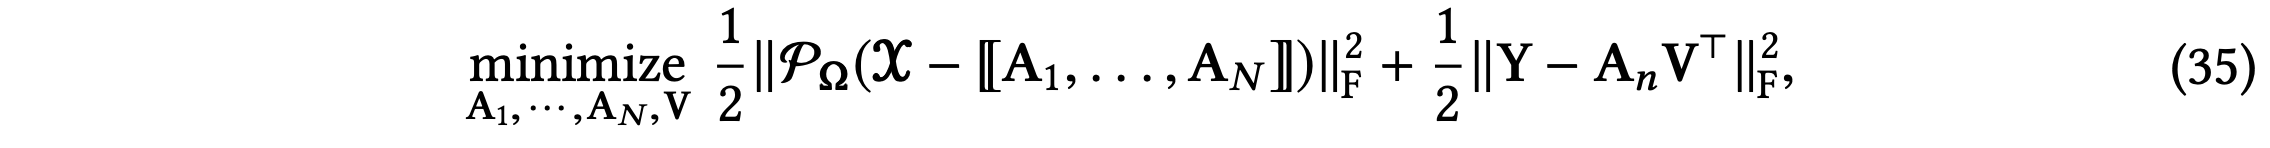
为了对large scale数据进行处理,研究者们又提出了scalable tensor completion算法,其主要解决了两个问题,第一个是张量在计算过程中通常需要unfolding成矩阵形式,这一中间过程会消耗非常大的储存空间。第二个则是如何将处理的数据合理分散化,也就是如何并行去处理。为了解决这些问题,通常会结合一些并行计算框架。
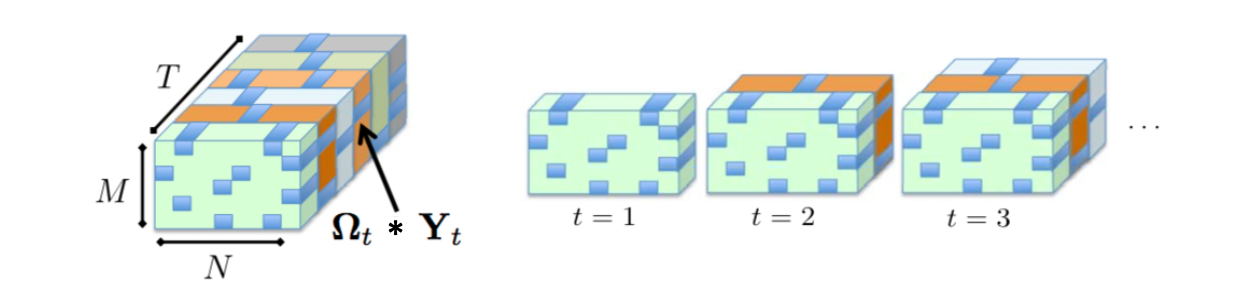
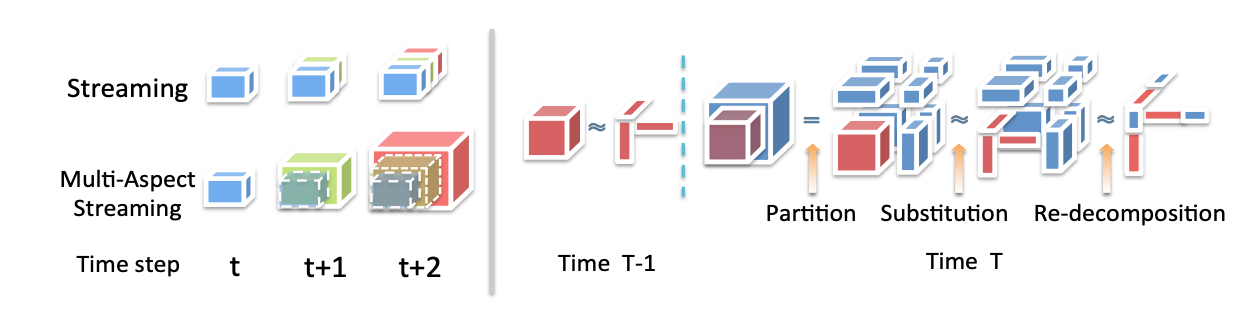
另一类非常吸引人的问题则是流数据处理问题,这类问题假定张量大小随着时间增长,需要实时进行处理。主要分为两类,第一类假定只有一个维度增长,这类问题比较常见,比如说在舆情分析过程当中,数据在时间维度上累积。第二类问题则是多个维度一起增长,对应的问题也更加复杂,如下图所示,
在未来的工作中,我们希望对streaming tensor analysis进行进一步的研究,更好的处理流数据来达到实时舆情分析。