本周阅读了论文Scalable Probabilistic Tensor Factorization for Binary and Count Data,这是一篇和我们工作非常相似且发表时间较近的论文。作者在文中考虑对binary和count类型的tensor进行分解,用到的技巧有Bayes共轭推断,Polya-Gamma augmentation、Gibbs采样、EM算法等,综合来看是一篇比较理论和技巧性都非常强的文章。下面我们介绍该文章的一些细节。
基于CP分解我们可以将模型写成如下形式,
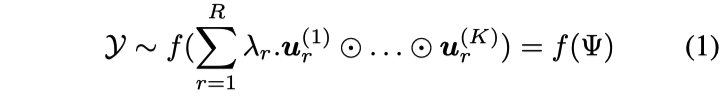
其中f对应于我们想采用的分布,传入的参数是一个三维的tensor,这和我们在ExpAirCP中的假定非常像,但是我们的f固定是exponential family的形式且传入的参数就是canonical parameter,从这点而言我们的模型更容易借助到一些指数分布族的理论性质。为了进一步化简我们记
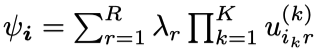
那么整个似然函数就可以写成
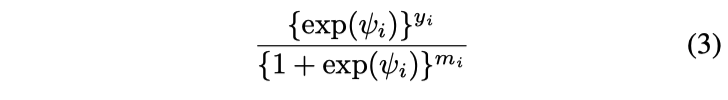
当m取不同值的时候分别可以对应到binary的情形与negative Binomial的情形。接下来采用Polya-Gamma augmentation技巧,将上式可以写成gaussian的形式,
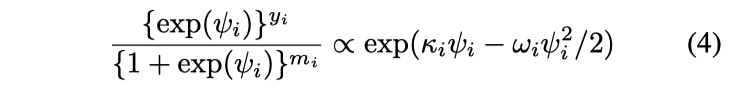
其中w就是从Polya-Gamma distribution中采样得来的。为了使用Gaussian先验的共轭性质,我们假定另外两个参数也服从Gaussian prior如下,
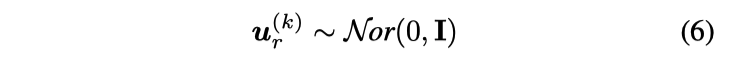
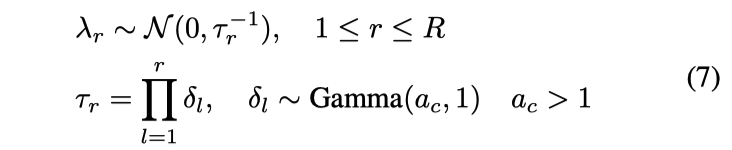
这样就使得后验分布同样是Gaussian的,那么第一种求解的方法很自然就是Gibbs采样,具体形式如下,我们现需要采样 ,然后采样
 ,这两者的均值和方差参数分别可以通过如下式子计算得来,
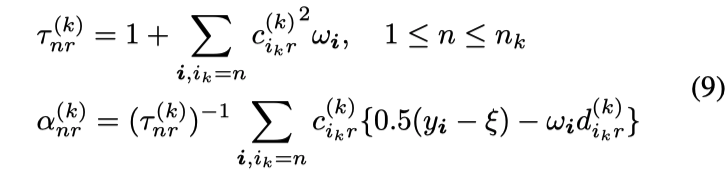
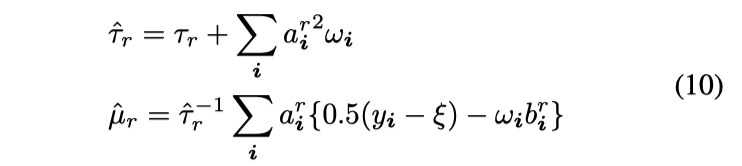
但这种方式计算量很大,所以作者提出了更好的EM算法作为改进,其中E步去计算w的期望,M步去最大化两个参数的的似然函数,
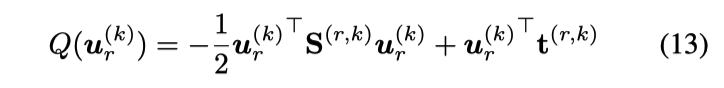
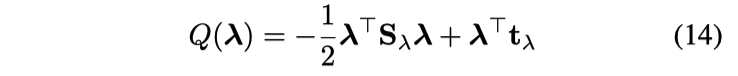
因为上式中的S和t均是tensor元素求和计算而来的,所以可以进一步变成online-EM算法,每一批数据进来后更新一次S和t,
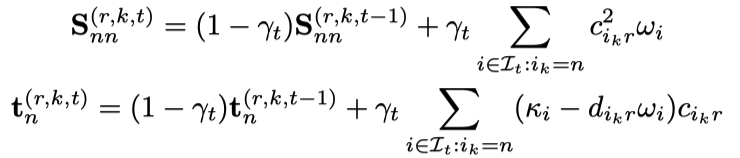
有了这一方法后,就不用整体去计算,而是随着数据的到来一次次更新计算,效率更高。也可以人为将全部数据划分为mini-batch来应用这一方法
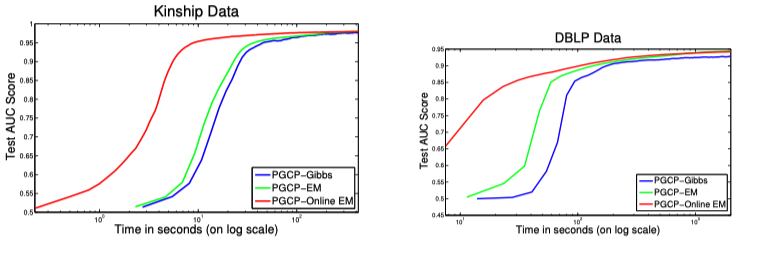
作者在实验部分探索了以下三点:
- 相同时间的情况下,采用哪种方式收敛的更快。
如果给factor matrix U矩阵添加一些非负限制,能得到什么结果。
Missing ratio不同的时候,这些算法效果如何。
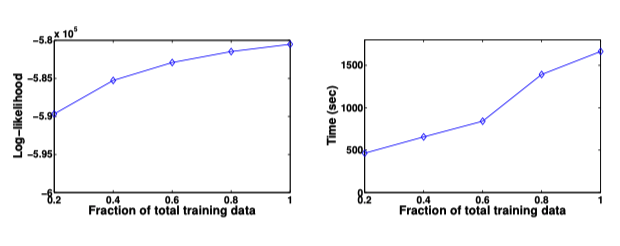
三个实验中Online-EM表现均不错。这篇文章所使用的方法是之前不曾见过的,很有启发。