最近阅读了Interpretable Machine Learning这本书,将书中内容简单进行了总结,分为上中下三部分笔记,分别是1)可解释的模型 2)模型无关方法的解释 3)基于样本的解释
第五章 模型无关的方法
个人总结:本章讲述了一下几个工具,我将其可使用性进行了评价。
- PDP可以看到某一变量取值对于最终预测的边际贡献值,缺点是不适用于变量有相关性的情况。
- ICE与PDP反映内容相同,但是展示的是每个样本的某一变量对于最终预测的贡献,缺点同上
- ALE 是部分依赖图 (PDP) 的更快、更无偏的替代方法。且当特征不独立的时候,ALE比PDP好用。推荐去实现
- 特征交互分析中的H统计量,用来看预测时每个变量与剩余所有变量交互强度的大小,我暂时没想到这有什么样的作用。
- 置换特征重要性。一种广义计算特征重要性的方法,不依赖于模型。推荐去实现
- 全局代理模型:用可解释性强的简单模型去近似复杂模型。我认为没啥用!
- 局部代理模型:用来解释个体预测值是受什么样的局部决策边界影响。我认为有点像是基于样本的解释。我觉得用处不大,但是书中比较多的出现
- Shapley值:给定当前的一组属性值,属性值对实际预测值与平均预测值之差的贡献就是估计的 Shapley 值。我认为这个可以用来解释某一个体为什么预测值比均值要低多少。推荐去实现有相同功能但是更加快和广泛的SHAP值
- SHAP值:基于博弈论上的最佳 Shapley 值,我认为这个是实现个体预测解释很好的工具!另外这也可以作为重要性度量去实现。推荐去实现
综上:去做model free解释性的时候,ALE、置换特征重要性、SHAP是三个我认为最值得去实现的工具。
介绍:
1)与模型无关 (也称模型不可知) 的解释方法的最大优势是它们的灵活性(独立于模型)。当解释方法可以应用于任何模型时,机器学习开发人员可以自由使用他们喜欢的任何机器学习模型。2)从可解释性来比较多个模型的时候,使用与模型无关的解释会更容易,因为相同的方法 可以用于任何类型的模型。
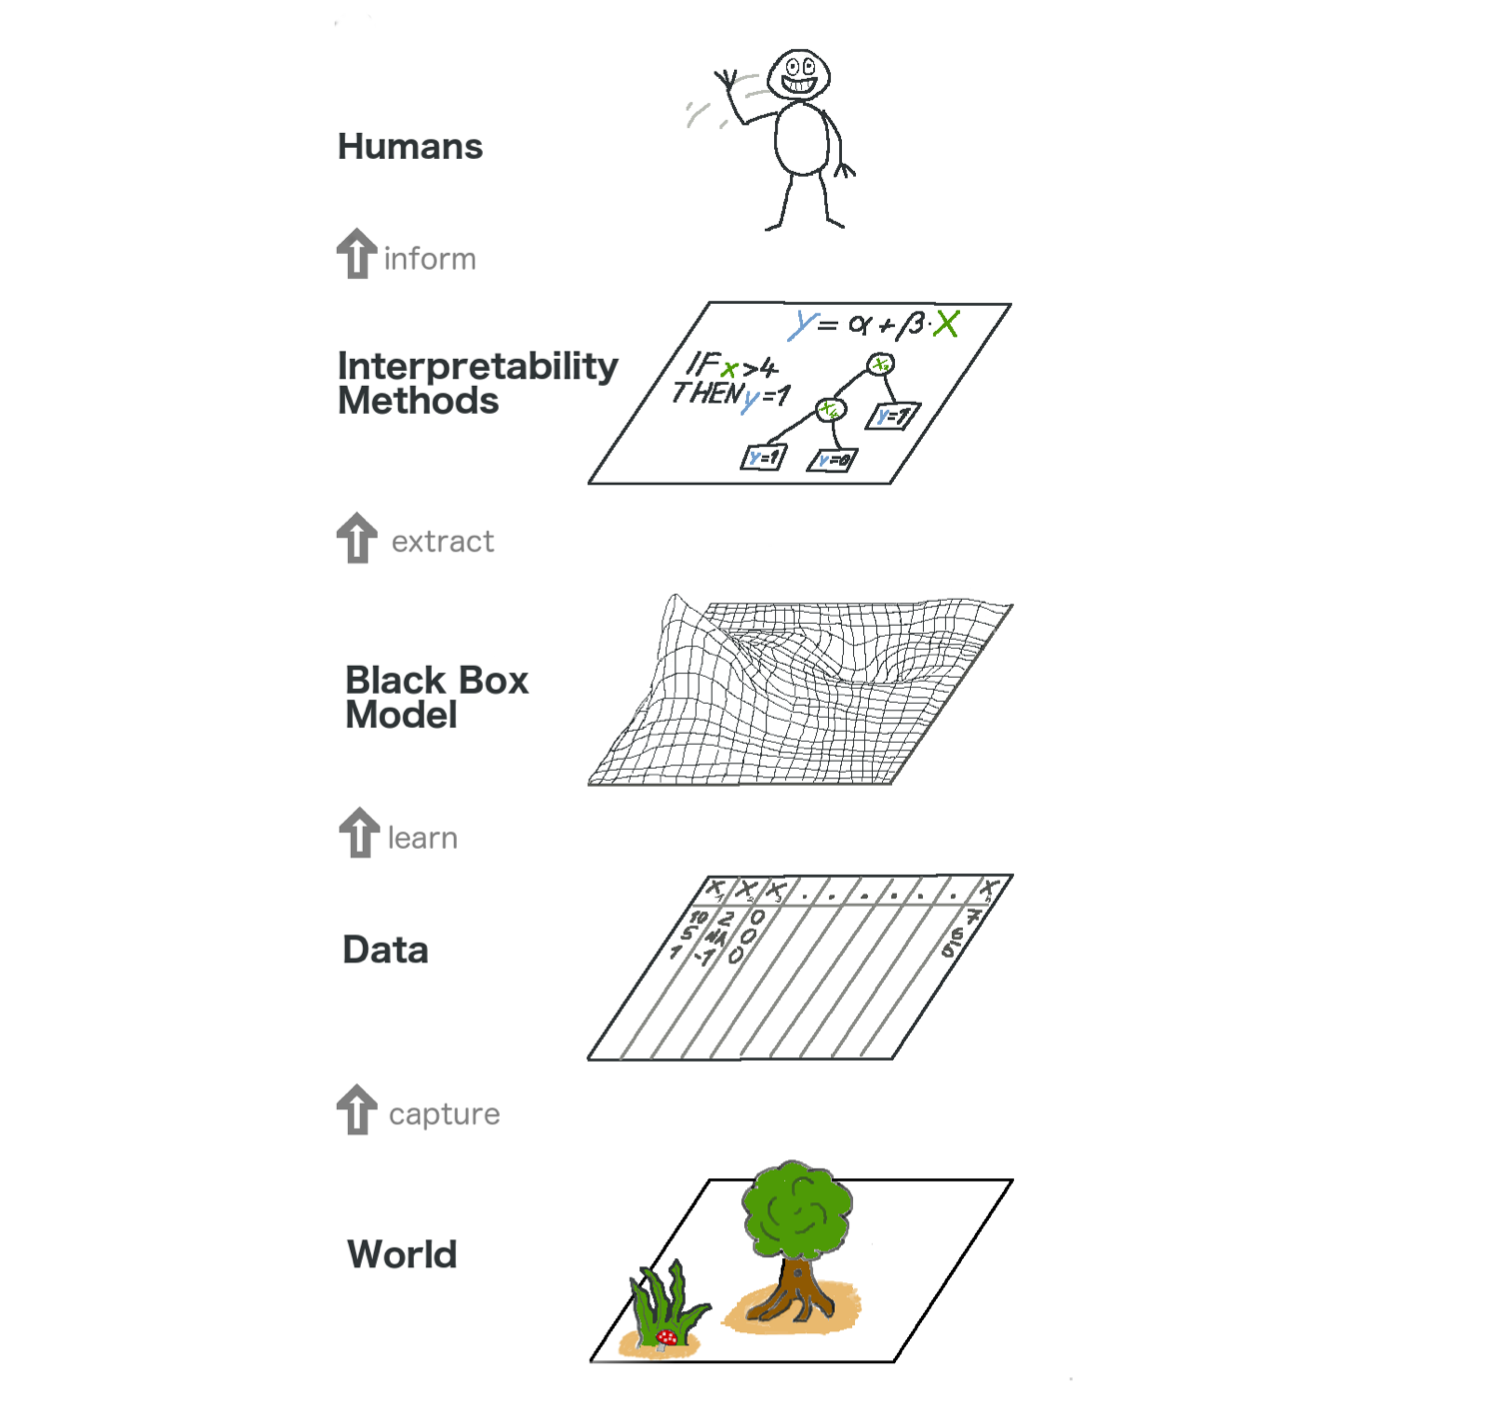
下图是个非常好的解释,将模型和解释分为两个层,先有模型之后,我们再来看其可解释性方法层
5.1 部分依赖图(Partial Dependence Plot)
PDP显示了**一个或两个特征**对机器学习模型的预测结果的边际效应,(预测结果对于一两个特征的部分依赖关系) **1. 考虑连续特征,**在回归中, $$ \hat{f}_{x_{S}}\left(x_{S}\right)=E_{x_{C}}\left[\hat{f}\left(x_{S}, x_{C}\right)\right]=\int \hat{f}\left(x_{S}, x_{C}\right) d \mathbb{P}\left(x_{C}\right) $$ 部分依赖函数告诉我们特征 S 的给定值对预测的平均边际效应是多少,求解时候可以通过MC方法,(**重点:因为上面求积分是dP(x_c),所以尽量都使用原始样本里面C属性的分布**) $$ \hat{f}_{x_{S}}\left(x_{S}\right)=\frac{1}{n} \sum_{i=1}^{n} \hat{f}\left(x_{S}, x_{C}^{(i)}\right) $$ PDP的**重要假设**是C 中的特征与 S 中的特征不相关。 **2. 考虑分类特征**,部分依赖很容易计算,为了计算 “夏季” 的值,我们将所有数据实例的季节替换为 “夏季”,然后对预测取平均值。 书上的例子是各类特征对于自行车租赁的影响,连续变量的话得到一个曲线,离散的话得到不同取值下的预测值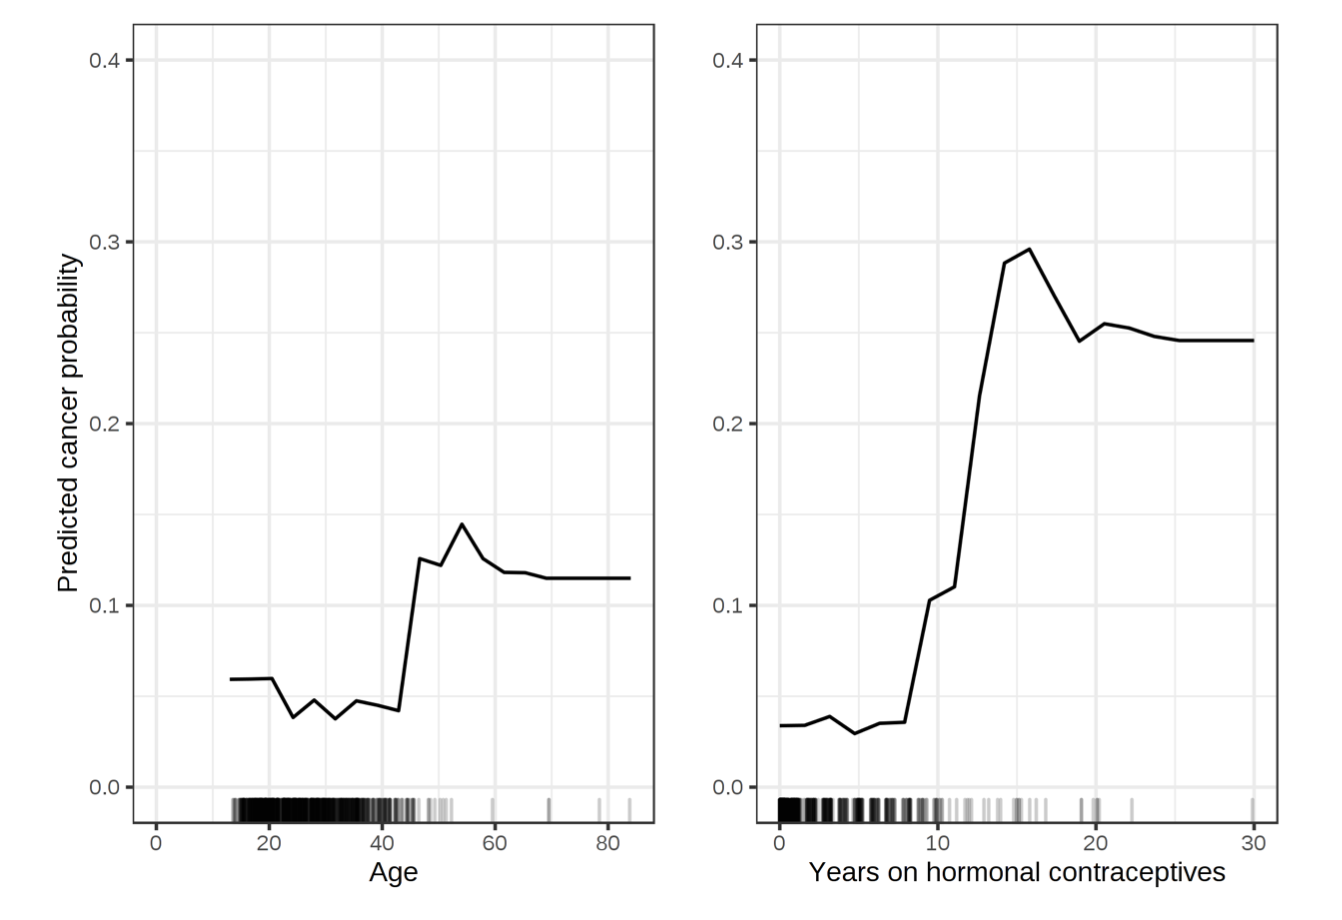 * 优点:部分依赖图的计算很直观:如果我们强制所有数据点都假定该特征值,则特定特征值处的部分依赖
函数表示平均预测。
* 缺点:1)最大特征数量为2,因为人脑想象不来更高维;**2)**PD 图未显示特征分布。忽略分布可能会产生误导,因为你可能会过度解释几乎没有数据的区域。所以通过再画一个分布直方图是一个比较好的辅助措施。3)独立性假设是最大的问题,解决方案是使用适用于条件分布的累积局部效应图或简称 ALE 图。4)**异质效应**可能被隐藏,因为 PD 曲线仅显示平均边际效应。假设只有两个点i和j,假设对于一个特征s,$c_i$的作用下s越大,预测值越大——$c_j$作用下s越小,预测值越大。PD 曲线可能是一条水平线,因为数据集这两个点的效果可能会相互抵消。然后,**错误得出结论该特征对于预测没有影响**
这里需要再理解下什么是异质性
5.2 个体条件期望 (Individual Conditional Expectation)
为了解决上面PDP的缺点4,我们使用ICE。为每个样本画一条预测线(C属性不变,S属性从小到大),共得到n条线。上述的PDP其实是ICE上所有线的平均值。如果ICE上所有曲线都遵循相同的路线,那说明没有明显的相互作用,没有异质效应。这意味着 PDP 已经很好地概括了S特征对机器学习模型的预测结果的边际效应。

ICE 图存在一个问题:有时很难判断 ICE 图在个体之间是否不同,因为它们从不同的预测开始。一种简单的解决方案是将曲线中心化于特征中的某个点,并仅显示到该点的预测差异。结果图称为中心化 ICE 图 (c-ICE)$\hat{f}{c e n t}^{(i)}=\hat{f}^{(i)}-\mathbf{1} \hat{f}\left(x^{a}, x{C}^{(i)}\right)$。中心化 ICE 图使比较单个实例的曲线变得更加容易。如果我们不希望看到预测值的绝对变化,而 是希望预测与特征范围的固定点相比的差异,这将很有用。
导数 ICE 图 (d-ICE)从视觉上更容易发现异质性:观察预测函数相对于特征的导数。但d-ICE 图需要很长时间才能计算出来, 这是不切实际的。
优点:一个曲线代表一个点的预测,更加直观;相比PDP来说更能揭示异质关系。
缺点:1)只能画一个特征,两个特征已经重叠到看不清。2)拥挤,可视化效果差。3)与 PDP 面临相同的问题:如果感兴趣的特征与其他特征相关联,则根据联合特征分布, 线中的某些点可能是无效的数据点。
5.3 累积局部效应(Accumulated Local Effects Plot)
能反映出和PDP相同想法的图,某个变量变化时会对预测值产生什么样的影响,但更加好用,如果之后需要用的话建议再深入看看理论。实习或许用得到描述了特征平均如何影响机器学习模型的预测。ALE 图是部分依赖图 (PDP) 的更快、更无偏的替代方法。且当特征不独立的时候,ALE比PDP好用。
比如x1 x2完全正相关,那么就不可能出现x1 = 0.7,x2=0.3的属性变量,计算条件分布时会过滤这种情况
如果机器学习模型的特征相关,则部分依赖图将不可信。计算与其他特征强相关的特征的部分依赖 图涉及对在实际中不太可能出现的人工数据实例的平均预测。这会极大地影响估计的特征效应。
理论:
PD,M 和 ALE 图在数学上有何不同?这三种方法的共同点是将复杂的预测函数 f 简化为仅依赖 一个 (或两个) 特征的函数。这三种方法都通过平均其他特征的效应来简化特征,但是在计算预测平均值或预测差异以及是否对边际或条件分布进行平均方面有所不同。
- PD对对边际分布的预测进行平均。要计算边际分布上的期望值,我们只需获取所有数据实例,强制它们对集合 S 中的特征具有特定的网格值,C属性按照各自原来的,平均此操作下数据集的预测值。
- M 图对条件分布的预测平均。
- ALE 图对预测的变化进行平均,然后将其累积在网格上
2与3的差异:1)$\hat{f}^{S}\left(x{s}, x{c}\right)=\frac{\delta \hat{f}\left(x{S}, x{C}\right)}{\delta x_{S}}$这一项其实是S区间中平均预测的变化,即梯度。2)比较来看ALE其实是M的积分形式。3)减去cons做中心化
问题:并不是所有模型都有梯度,比如随机森林
计算
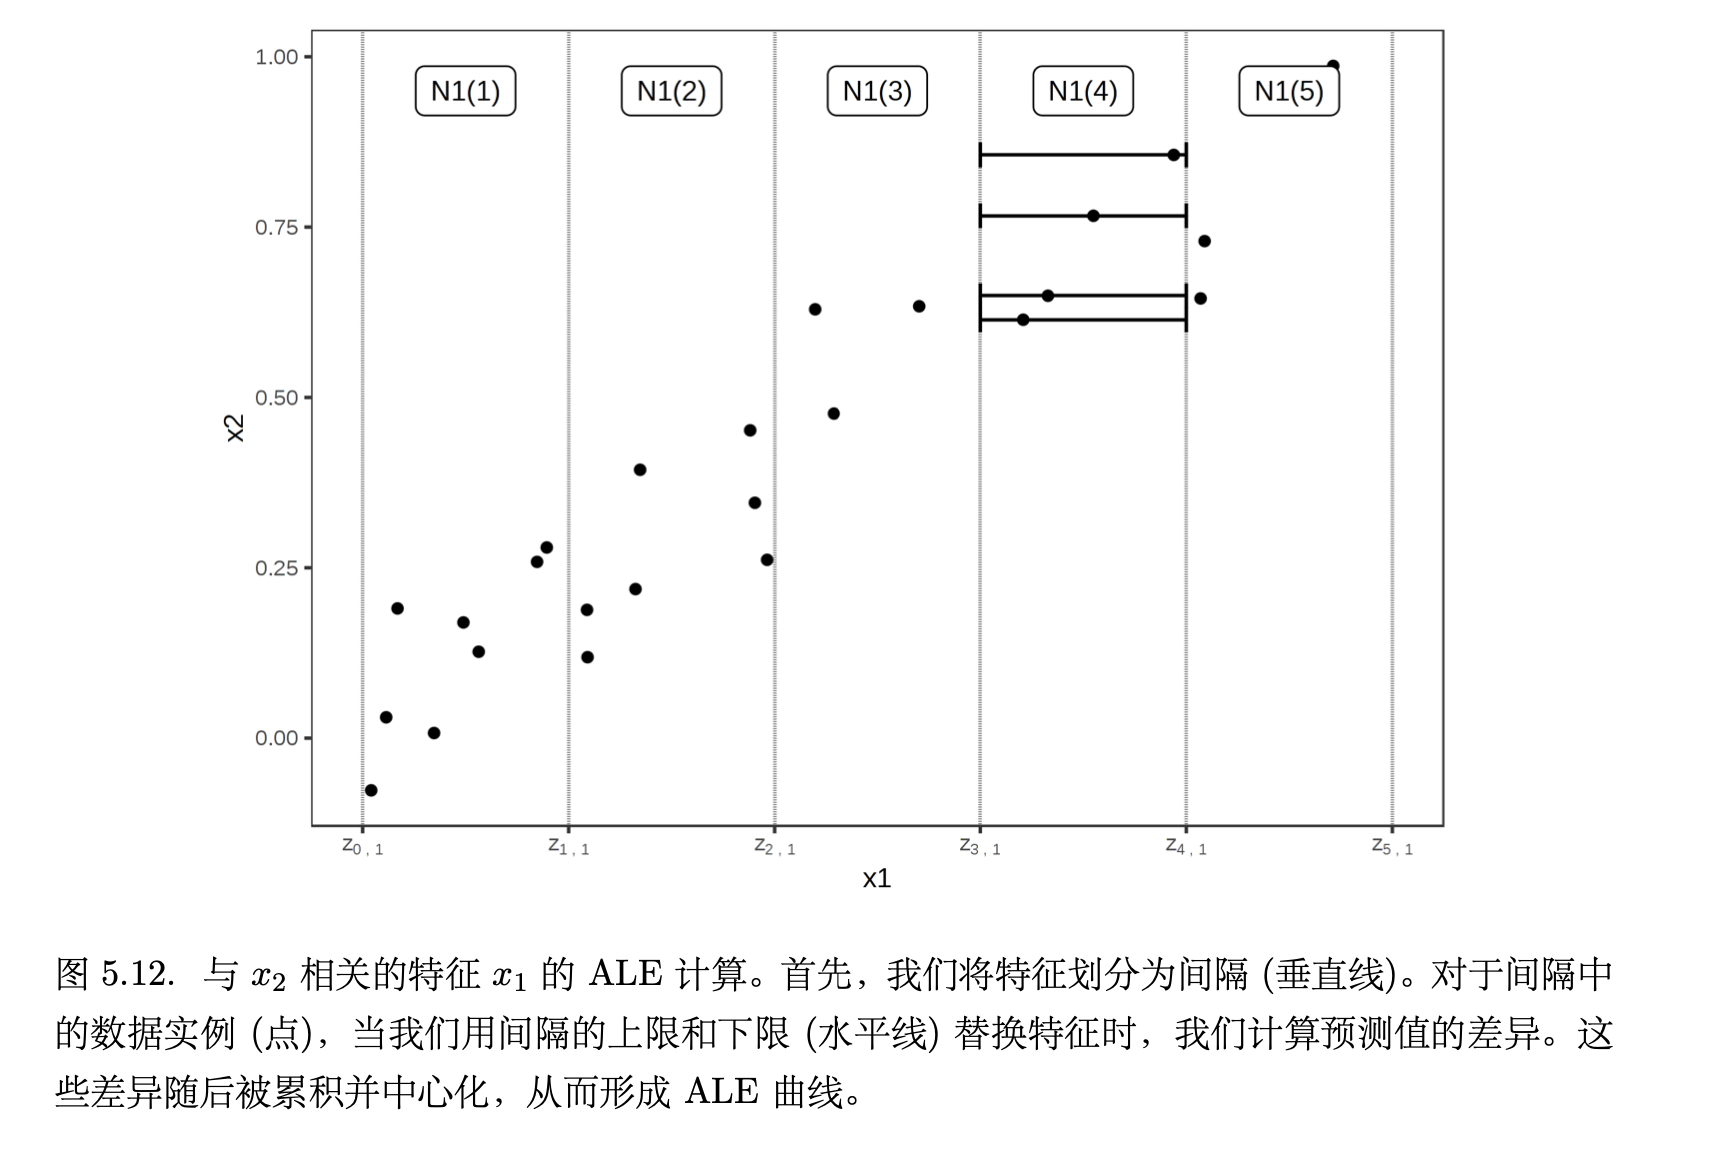
为了估计局部效应,我们将特征划分为许多区间并计算预测值之间的差异。此过程近似梯度,也适用于没有梯度的模型。先计算非中心化效应,
再将效应中心化,因此平均效应为零,
对于二维数值特征,做 2D ALE 图,计算就从间隔变成了矩阵间隔
例子
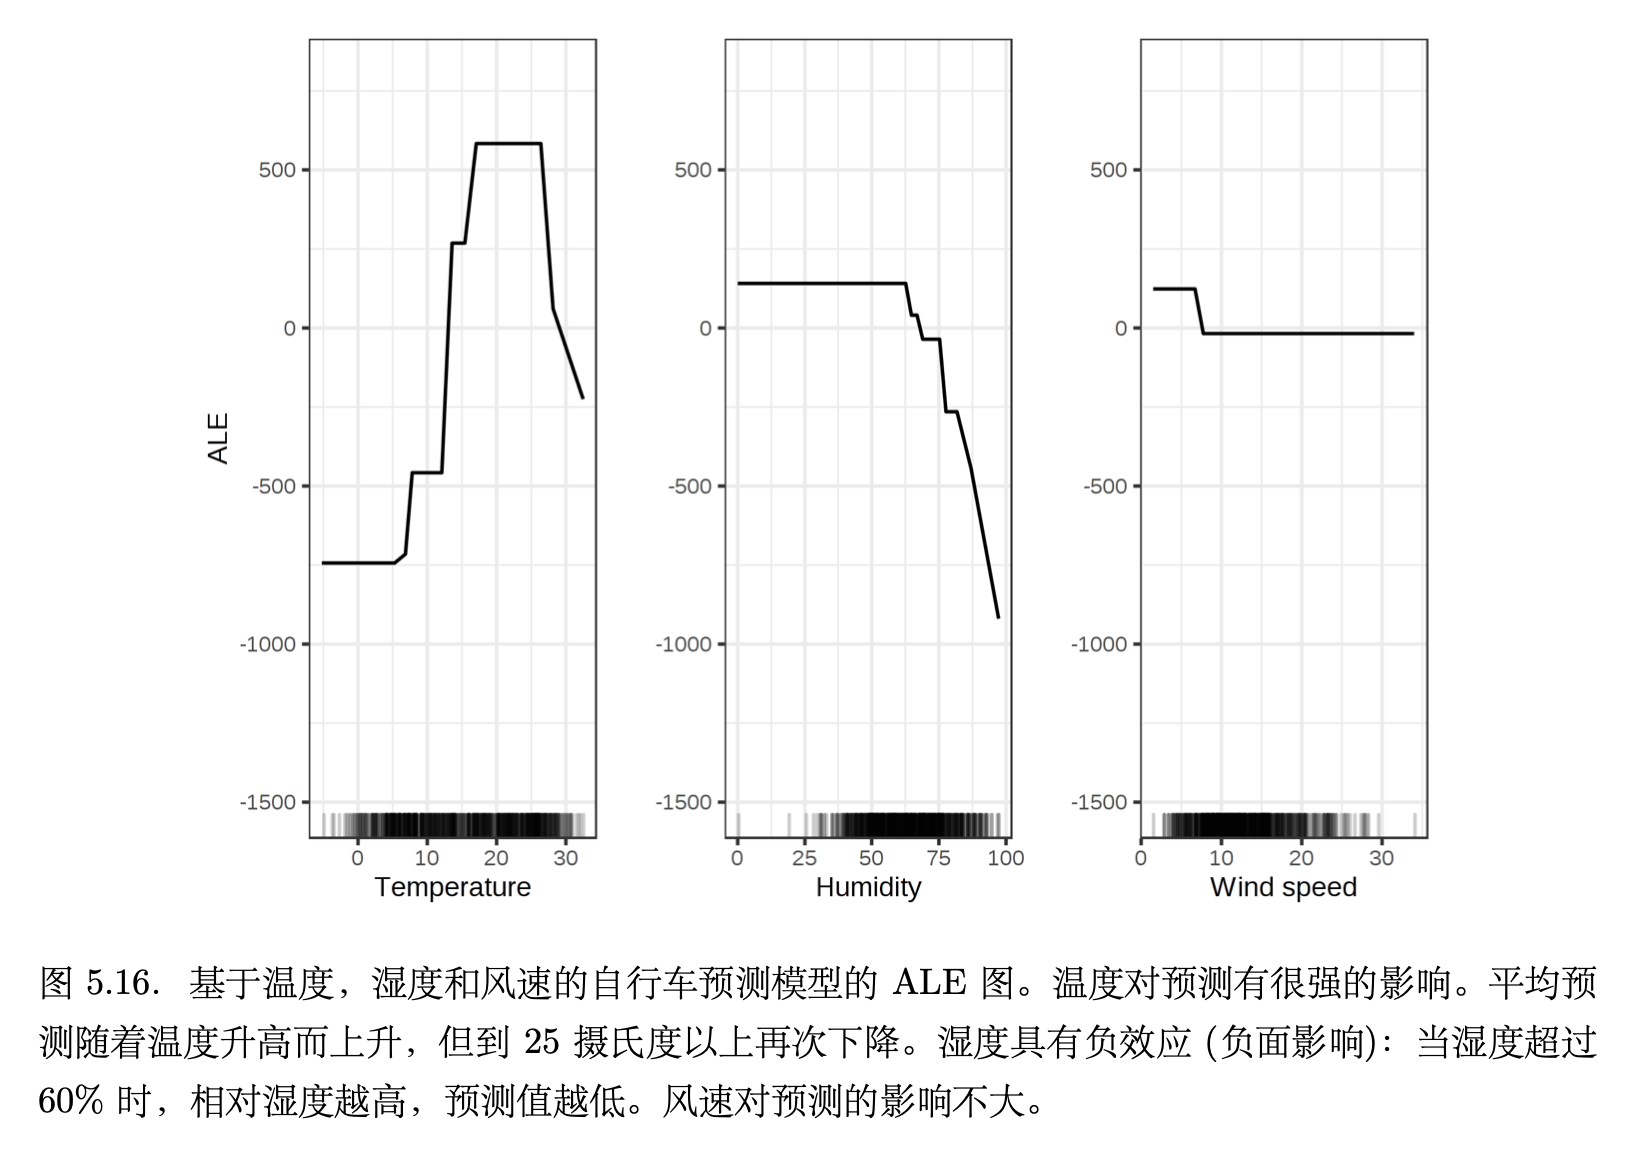
优点:1)ALE 图是无偏的,这意味着在特征相关时它们仍然有效。在这种情况下,部分依赖图将失败,因为它们会计算不可能的特征值组合。2)ALE 绘图的计算速度比 PDP 更快。3)ALE 图的解释很清楚:在给定值的条件下,可以从 ALE 图中读取更改特征对预测的相对影响(相对是指ALE 图以 0 为中心。这使它们的解释更好,因为 ALE 曲线每个点的值都是与平均预测之差)。
总而言之,在大多数情况下,宁愿使用 ALE 图而不是 PDP 图,因为特征通常在某种程度上相关。缺点:1)间隔数过大时图形不稳定。2)实现更加复杂且不直观。3)目前仅在R语言中有实现
5.4 特征交互的分析(暂时没想到有什么实际用处)
特征交互 (Feature Interaction) :当特征在预测模型中交互时,预测不能表示为特征效应的总和,因为一个特征的效应取决于另一特征的值。如果机器学习模型基于两个特征进行预测,则可以将预测分解为四项:常量项,第一个特征项,第二个特征项以及两个特征间的交互项。
- 估计交互强度的一种方法是衡量预测的变化在多大程度上取决于特征的交互作用。这项衡量称为 H 统计量,
- 特征j和k之间的H统计量为:
- 度量特征 j 是否与任何其他特征交互:
特点:H 统计量的评估成本很高,因为它会在所有数据点上进行迭代,并且必须在每个点处评估部分依 赖,而这又需要对所有 n 个数据点进行。在最坏的情况下,我们需要 $2n^2$ 调用机器学习模型预测 函数来计算双向 H 统计量 (j vs. k),并需要 $3n^2$ 以获得总体 H 统计量 (j vs. all)。
例子
一般先查看每个特征与所有其他特征的特征交互量,然后可以选择其中一个H值大的特征,更深入地研究所选特征与其他特征之间的所有双向交互。
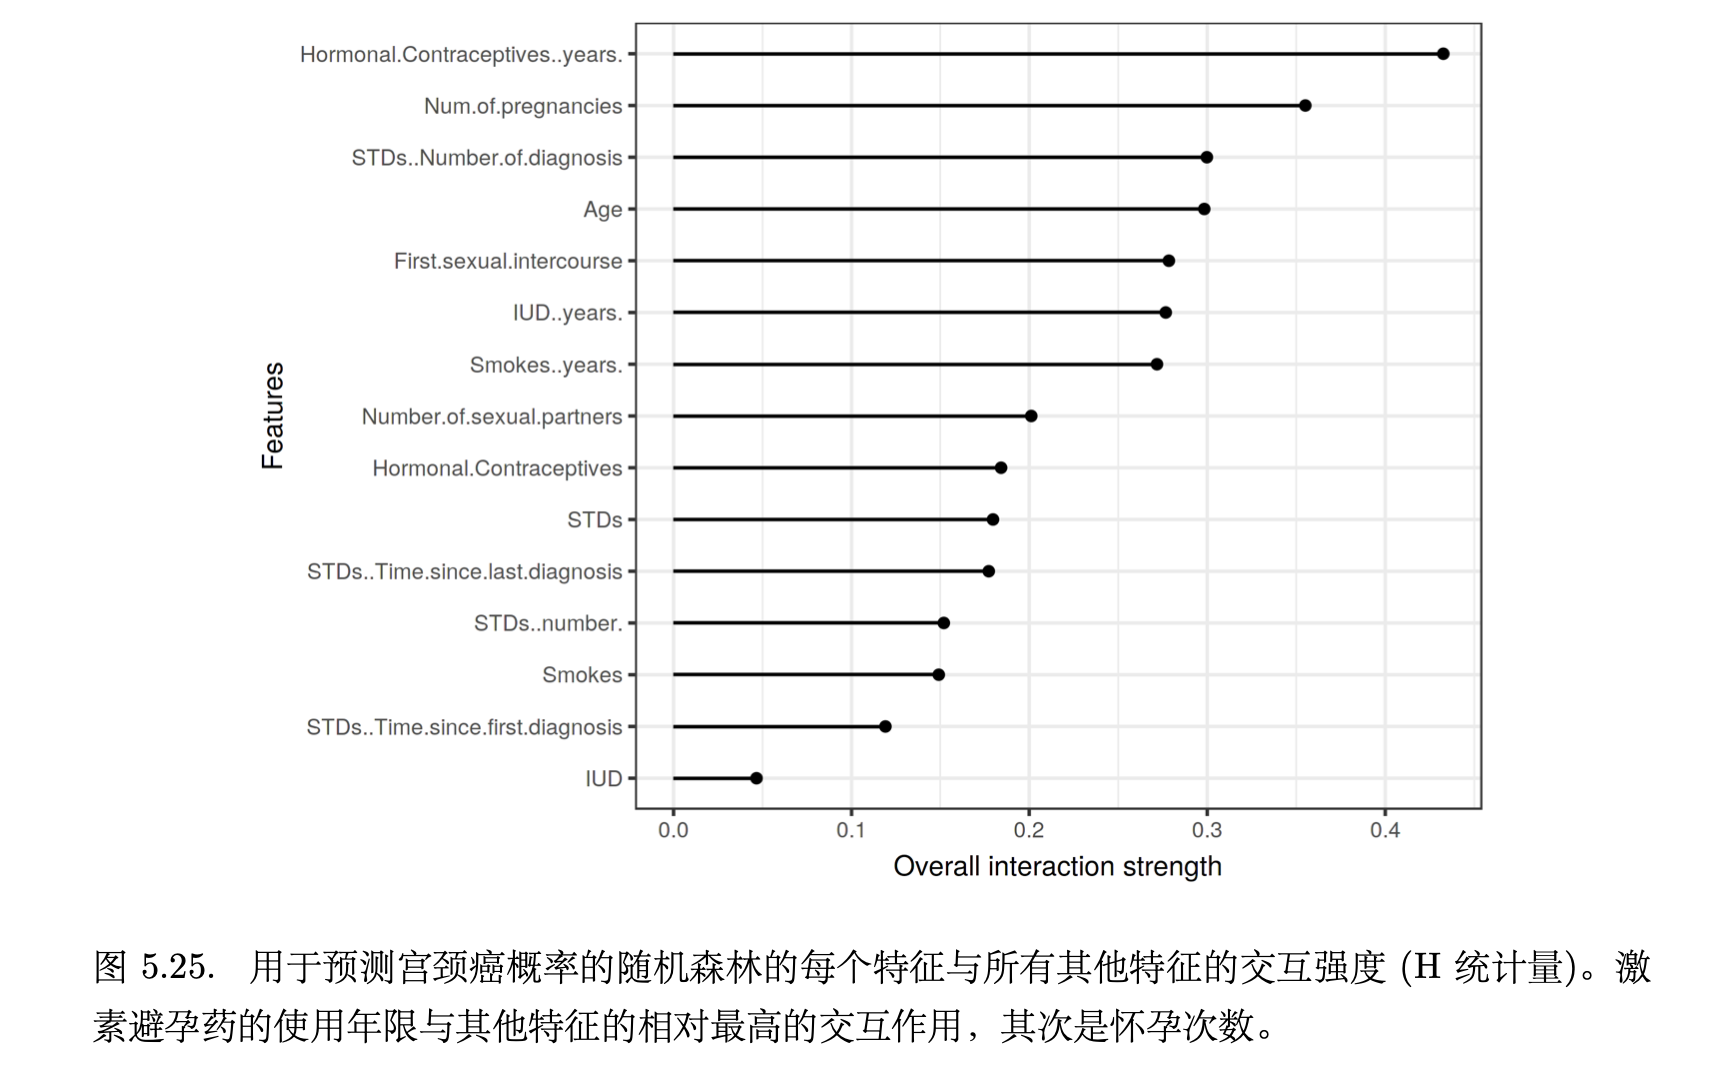
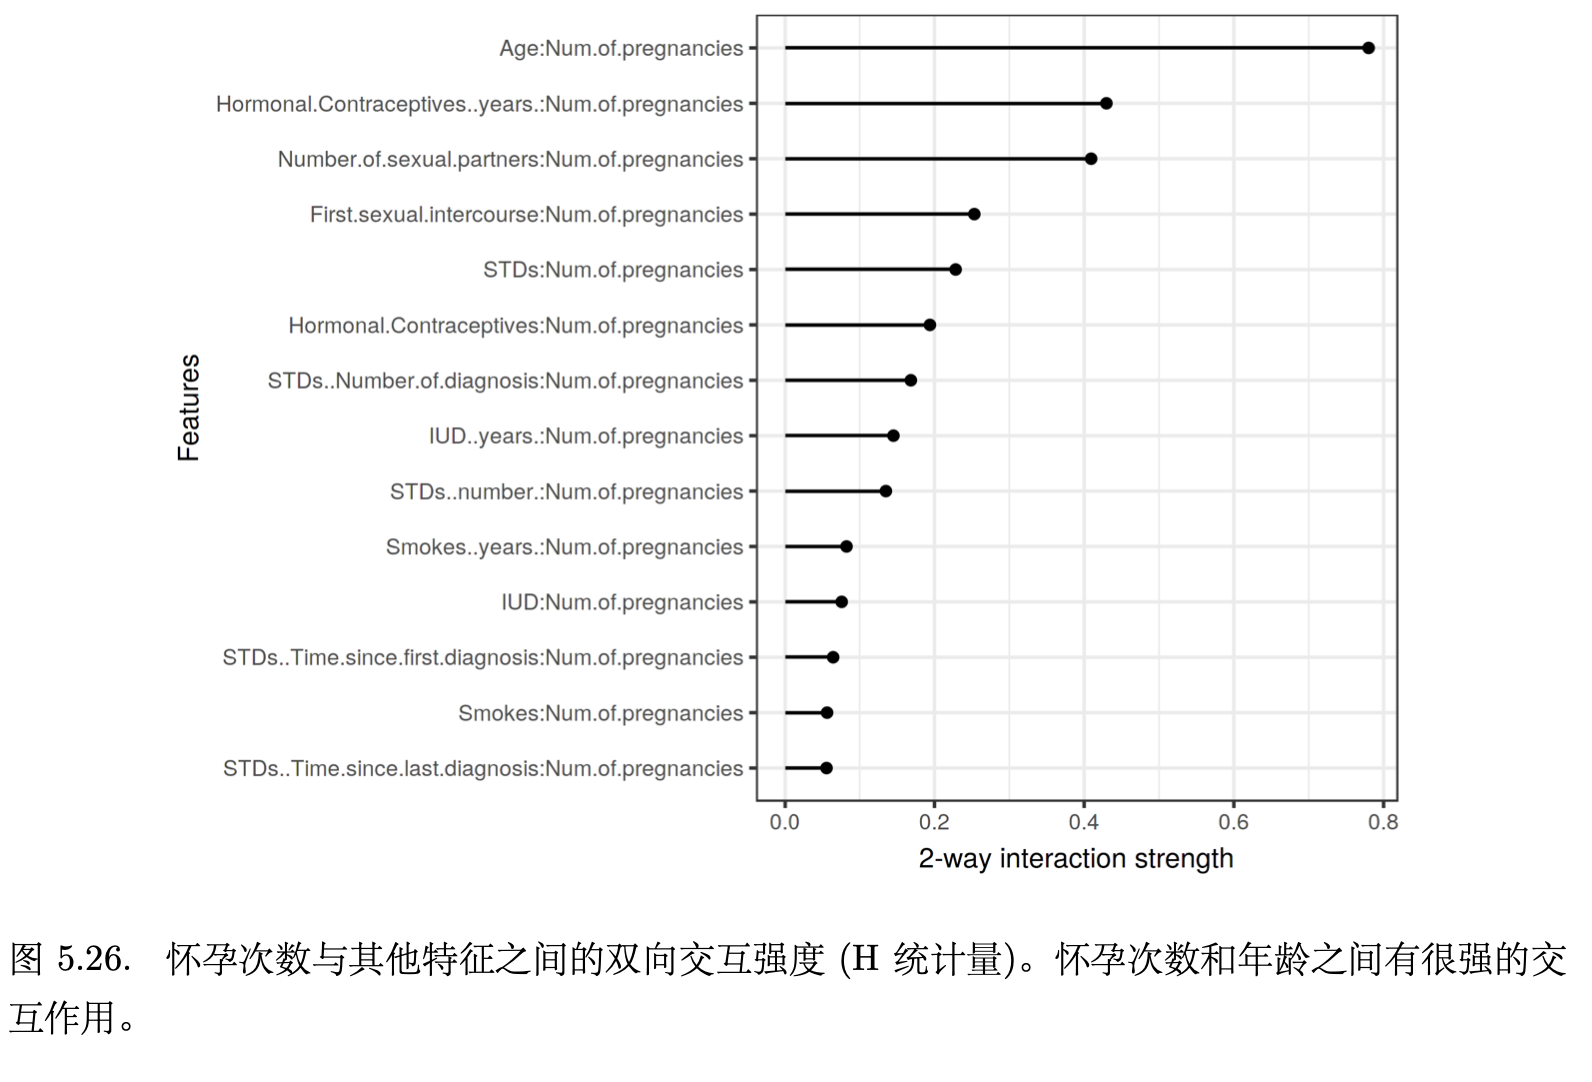
优点:理论基础、有意义的解释(H定义为由交互作用解释的方差份额)、0到1之间在不同模型间有可比性
缺点:计算量很大、H多大时称为“强”
5.5 置换特征重要性(用于计算变量的重要性,model free,实习可以尝试用,比起之前模型限定的重要性度量,这个好用太多。可以神经网络、RF)
我们通过置换特征后计算模型的预测误差的增加来衡量特征的重要性。如果将 特征的值改变会增加模型误差,则该特征 “重要”,因为在这种情况下,模型依赖于特征进行预测。 如果将特征的值改变而使模型误差保持不变,则特征 “不重要”,因为在这种情况下,模型会忽略 预测的特征。
一种广义计算特征重要性的方法,不依赖于模型 Fisher、Rudin 和 Dominici (2018)[31] 提出了特征重要性的模型无关版本,并将其称为模型依赖 (Model Reliance) 未详细看定义与idea,需要的时候再看,下面是一个例子。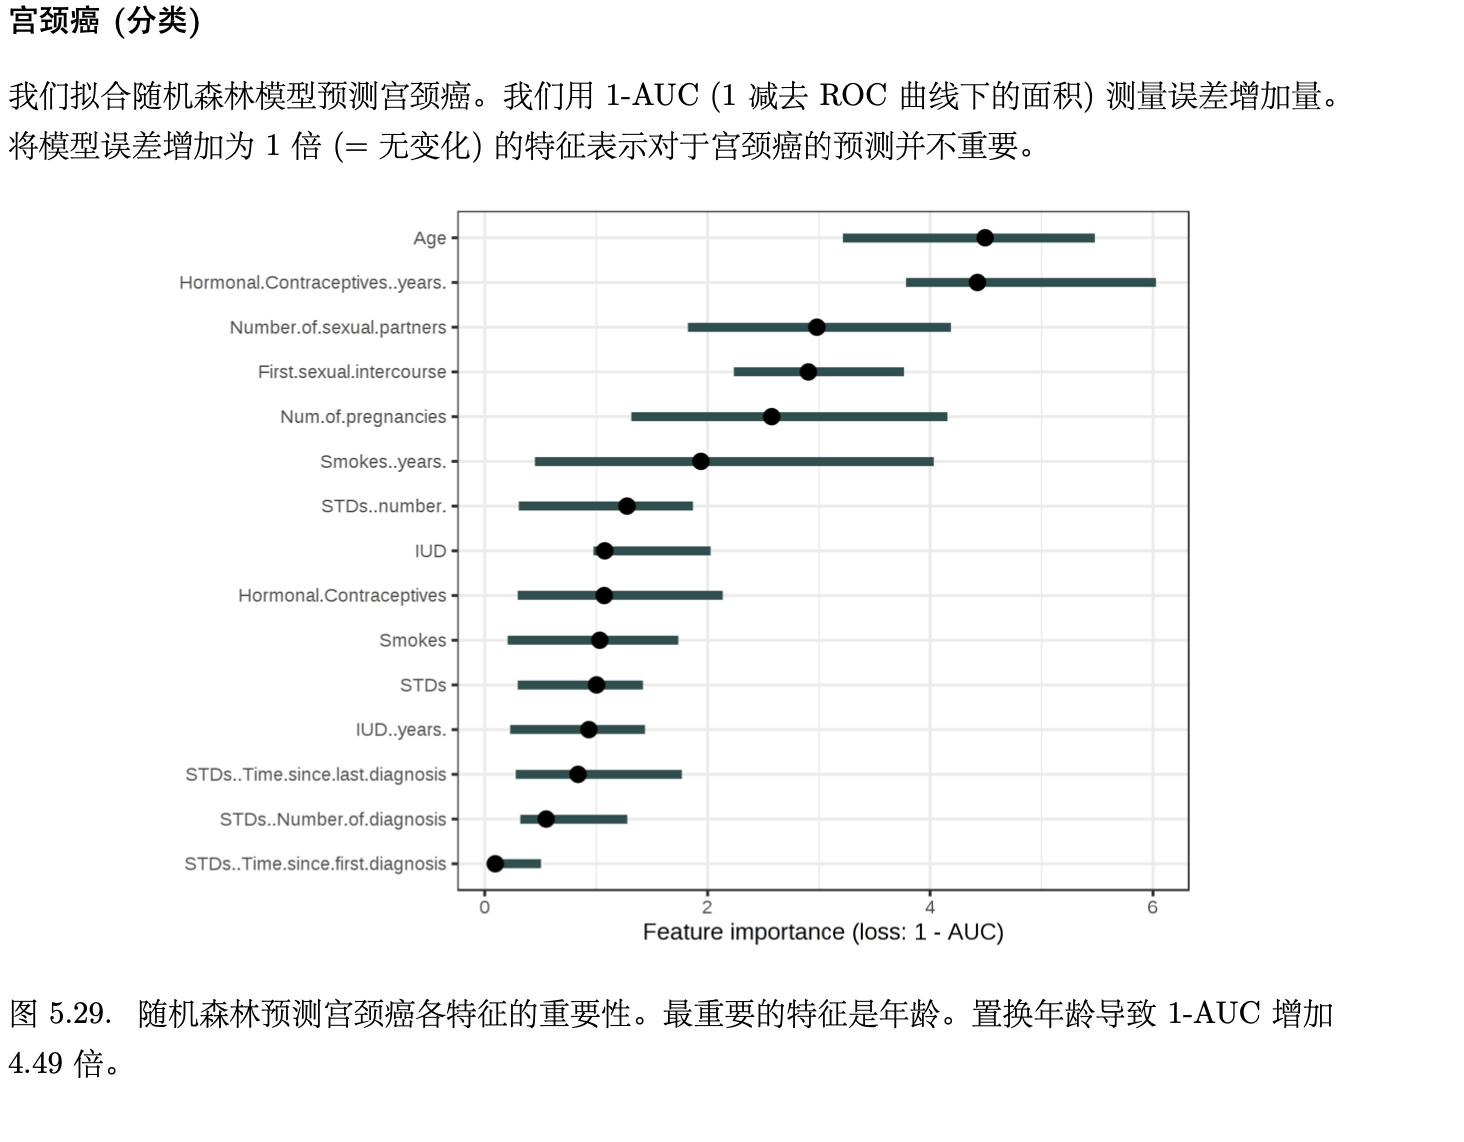 优点:1)很好的解释:特征重要性是当特征信息被破坏时模型误差的增加。2)提供了对模型行为的高度压缩的、全局的洞悉。3)不需要重新训练模型(其他一些方法建议删除特征,重新训练模型,然后比较模型误差,比起这个方法时间很久)
缺点:1)非常不清楚应该使用训练数据还是测试数据来计算特征的重要性。2)重复置换后,结果可能会有很大差异。3)如果特征是相关的,则置换特征重要性可能会因不切实际的数据实例而有偏差。
## 5.6 全局代理模型(我认为这个工作比较无聊,例子:决策树去近似复杂模型的预测)
理论:我们希望在 g 可解释的约束下,代理模型 预测函数 g 尽可能接近地逼近我们的黑盒预测函数 f。对于函数 g,可以使用任何可解释的模型。训练代理模型是一种与模型无关的方法,因为它不需要有关黑盒模型内部运作的任何信息,仅需要 访问数据和预测。
训练流程:1)对于选定的数据集 X,获取黑盒模型的预测。2)选择一种可解释的模型类型 (线性模型,决策树等)。3)在数据集 X 及其预测上训练可解释模型。4)衡量代理模型复制黑盒模型预测的效果(可使用R-square来看可解释模型可否替换复杂模型)。 5)解释代理模型。
优点:灵活、直观、R平方度量表现
缺点:得到的是有关模型而不是数据的结论,选择的可解释的代理模型本身的所有优点和缺点。
## 5.7 局部代理模型(Local interpretable model-agnostic explanations,LIME。用来解释个体预测值是受什么样的局部决策边界影响。我认为有点像是基于样本的解释)
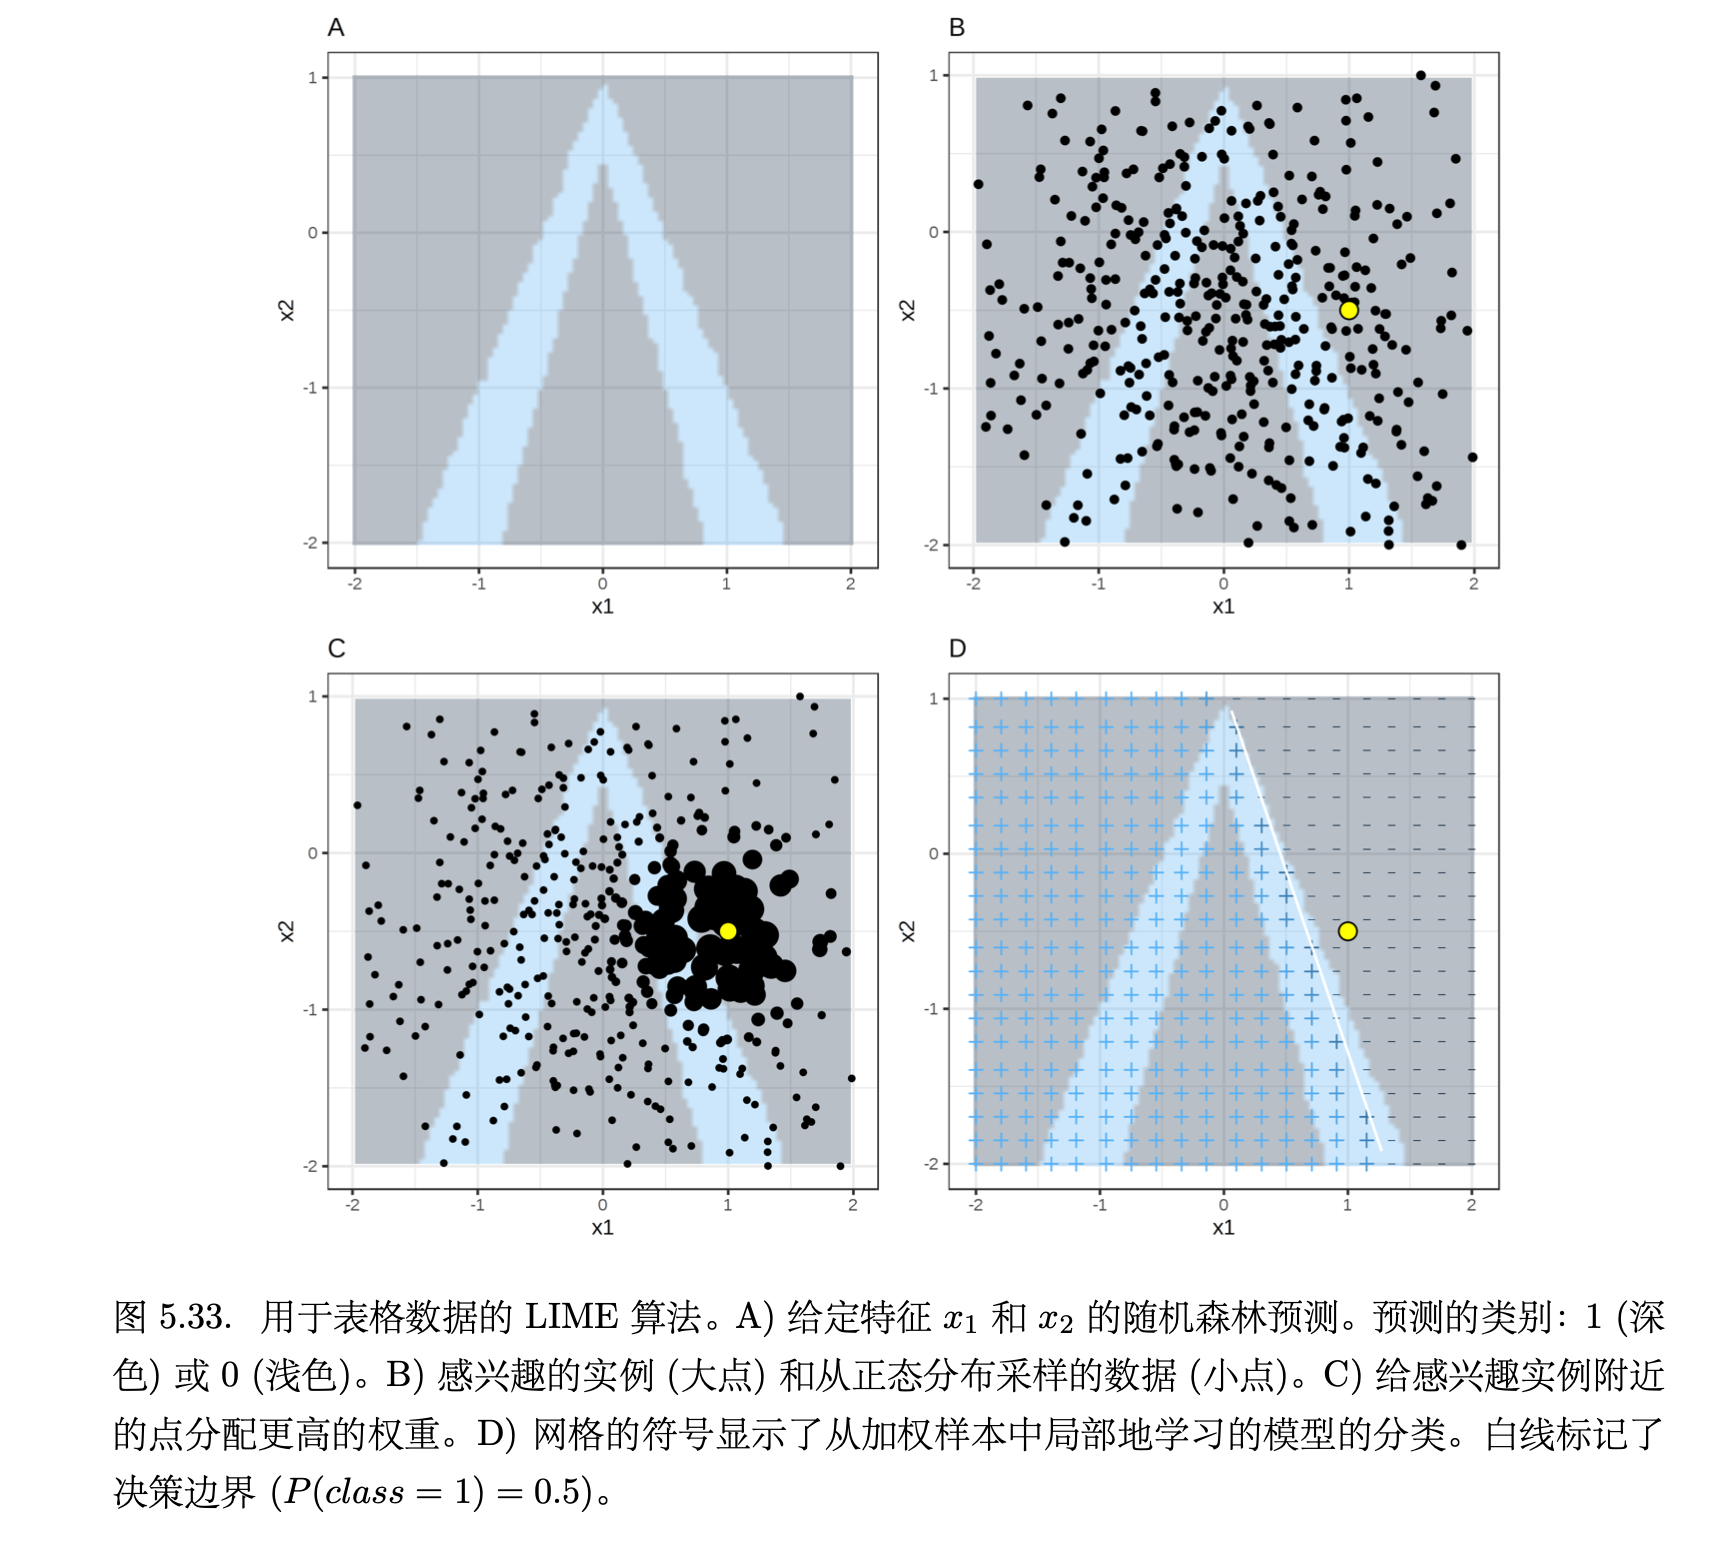
局部代理模型本身是可解释的模型,用于解释黑盒机器学习模型的单个实例预测。LIME 并非训练全局代理模型,而是专注于训练局部代理模型以解释单个预测。
LIME 生成一个新的数据集, 该数据集由扰动的样本和黑盒模型的相应预测组成。然后,在这个新的数据集上,LIME 训练了一 个可解释的模型。在数学上,具有可解释性约束的局部代理模型可以表示为:
$$
\operatorname{explanation}(x)=\arg \min _{g \in G} L\left(f, g, \pi_{x}\right)+\Omega(g)
$$
**训练局部代理模型的方法:**1) 选择你想要对其黑盒预测进行解释的感兴趣实例。2) 扰动你的数据集并获得这些新点的黑盒预测。3) 根据新样本与目标实例的接近程度对其进行加权。 4)在新数据集上训练加权的,可解释的模型。5)通过解释局部模型来解释预测。
下图就是训练及解释的过程,先训练,然后得到局部的决策边界来解释
 优点:1)解释与模型分离2)少数适用于表格数据,文本和图像的方法之一。3)python LIME package有实现
缺点:以 LIME 作为具体实现的局部代理模型非常有应用前景。但是该方法仍处于开发阶段,需要解决许多问题才能安全应用。
## 5.8 Shapley值(给定当前的一组属性值,属性值对实际预测值与平均预测值之差的贡献就是估计的 Shapley 值。我认为这个可以用来解释某一个体为什么预测值比均值要低多少。非常好的工具,它的拓展是下一节的SHAP,理解shapley后最好使用SHAP)
例子:公寓的大小为 50 平方米,位于 2 楼,附近有公园,并且禁止猫入内,预测价格300,000,所有公寓的平均预测价格为 310,000 欧元。想知道与平均预测相比,减少的这10,000中每个属性值对预测有多少贡献?
思路:Shapley 值 (由 Shapley (1953)[33] 创造) 是一种根据 玩家对总支出的贡献分配支出给玩家的方法。**Shapley 值是所有可能的联盟 (Coalition) 中特征值的平均边际贡献。这么说清楚了吗?**(个人理解,如果特定于“禁止猫进入”这一属性的Shapley值而言,这里可能的联盟是指将其他属性进行组合)
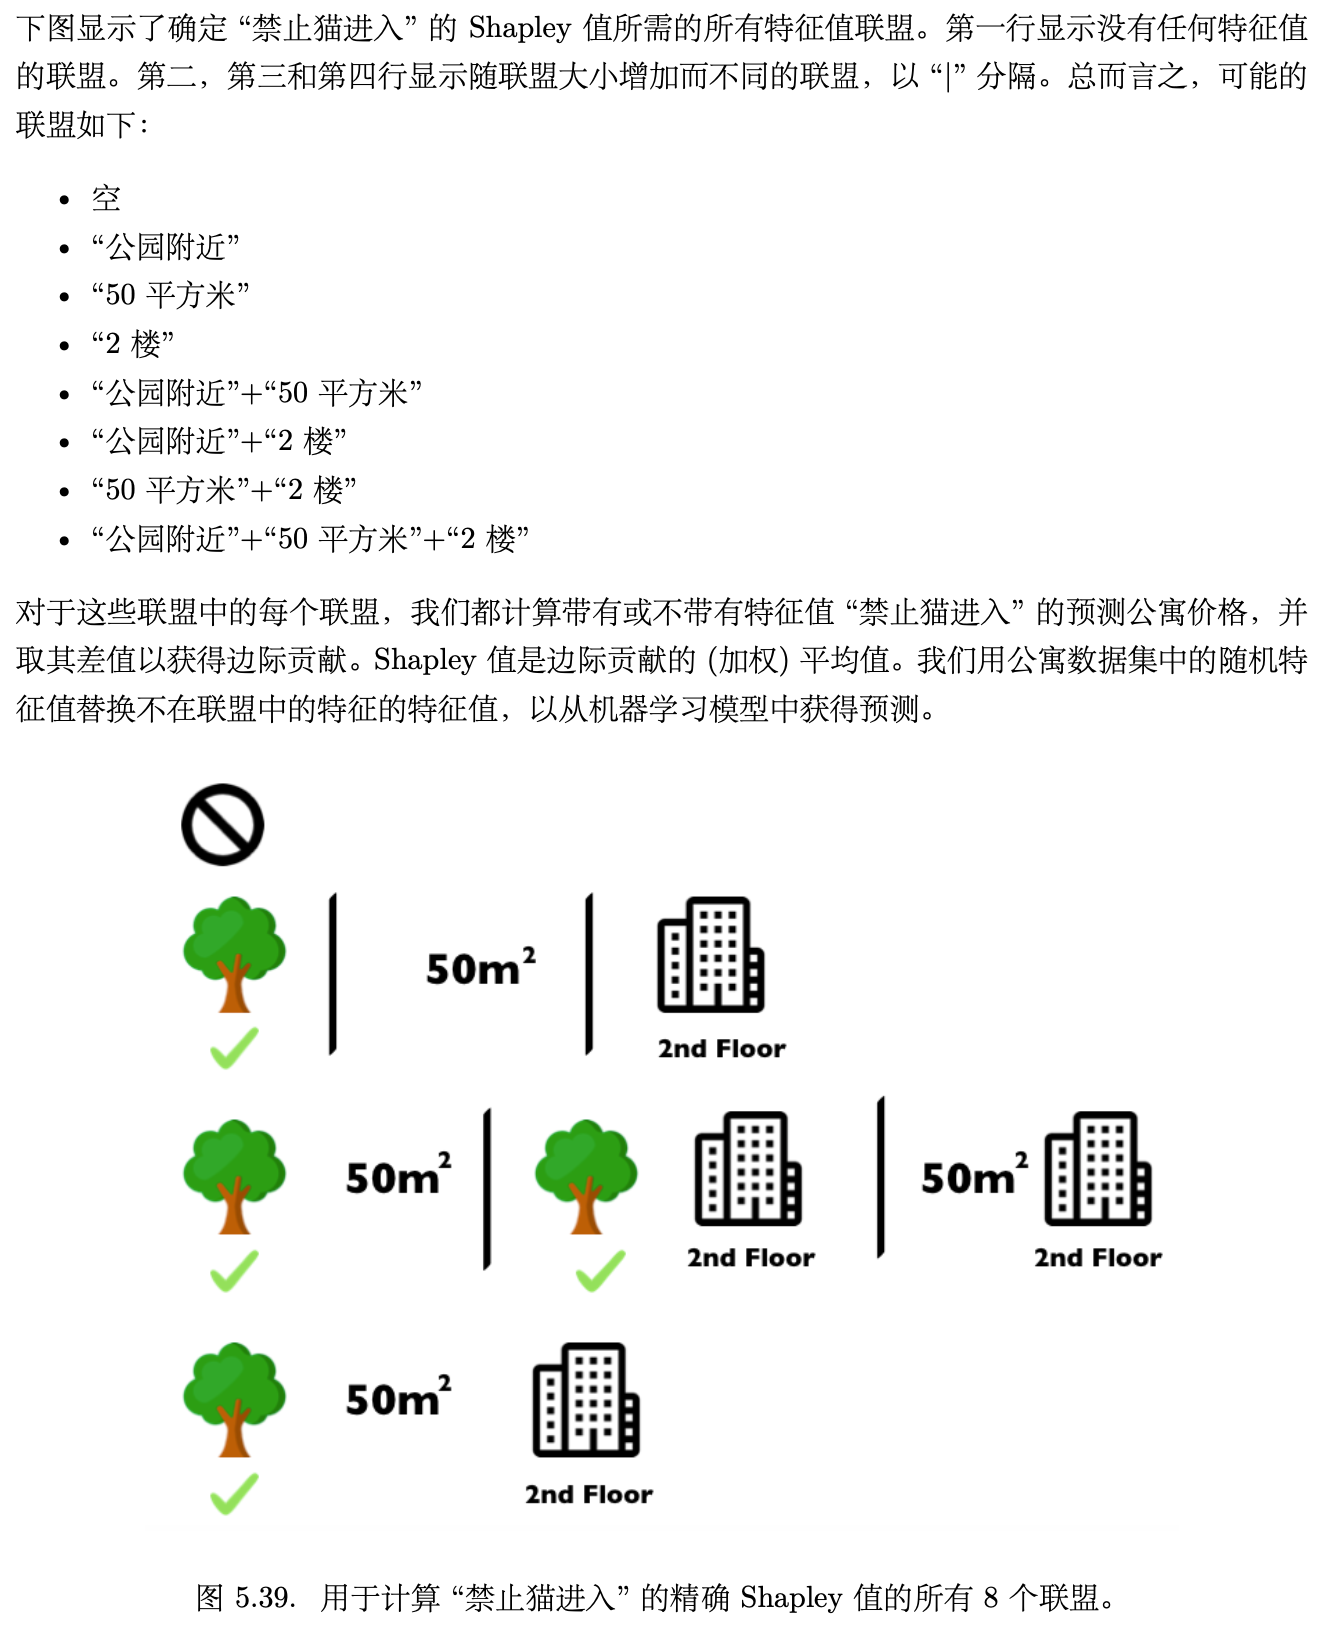
示例与解释:
特征值 j 的 Shapley 值的解释是:与数据集的平均预测相比,第 j 个特征的值对这个特定实例的预测的贡献为 φj。
Shapley适合解释分类(预测是概率)与回归问题。如下面的例子,1)每个特征对与女性患癌的概率比平均预测 值 0.03 高 0.54做了多大贡献。2)自行车例子
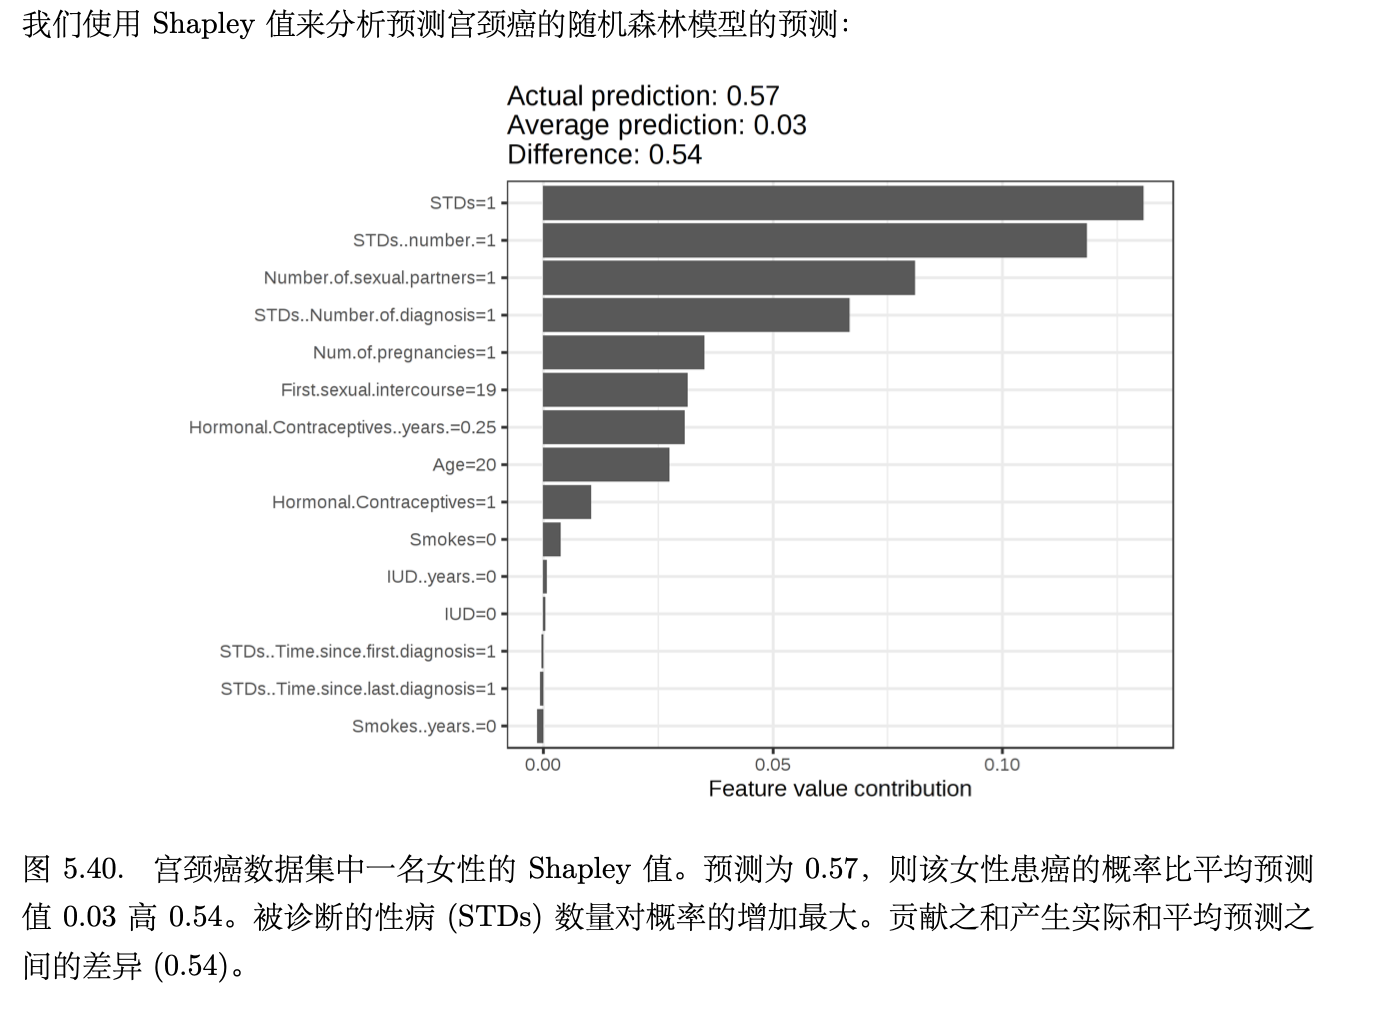
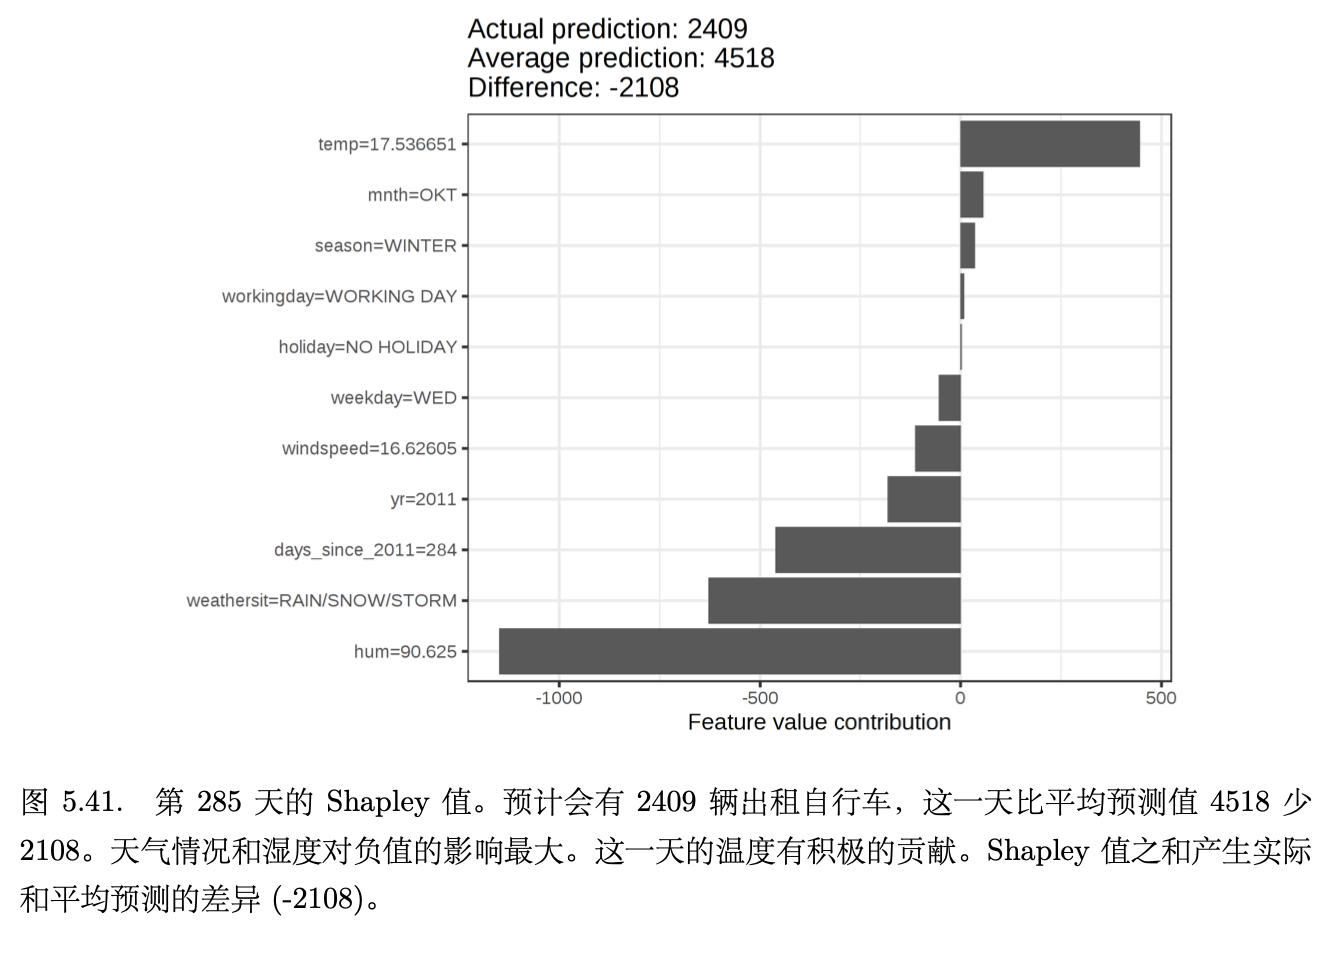
计算:精确计算复杂度极大,所以大多使用蒙特卡洛近似
特点:Shapley 值是唯一满足效益性 (Efficiency),对称性 (Symmetry),虚拟性 (Dummy) 和可加性 (Additivity) 的归因方法,这些性质一起可以视为公平支出的定义。
优点:1)预测值与平均预测值之间的差异在实例的属性值 (即各属性的 Shapley 值) 之间公平分配。2)Shapley 值允许进行对比性解释。你可以将其与子集甚至单个数据点进行比较。这种对比也是像 LIME 这样的局部模型所不具备的。 3)Shapley 值是唯一具有扎实理论的解释方法。公理——效益性,对称性,虚拟性,可加性——为解 释提供了合理的基础。
缺点:1)由于计算复杂,大多数情况只能近似计算。2)可能会被误解。特征值的 Shapley 值不是从模型训练中删除特征后的预测值之差。精确解释是:给定当前的一组特征值,特征值对实际预测值与平均预测值之差的贡献就是估计的 Shapley 值。3)计算时可能会遇到不现实的数据实例。4)目前只在R语言中有看到
5.9 SHAP(基于博弈论上的最佳 Shapley 值,我认为这个是实现个体预测解释很好的工具!另外这也可以作为重要性度量)
SHAP 的目标是通过计算每个特征对预测 x 的贡献来解释实例 x 的预测。SHAP 解释方法根据联盟博弈理论计算 Shapley 值。
Shapley 值是唯一满足效益性、对称性、虚拟性和可加性的解。SHAP 也满足这些要求,因为它可 以计算 Shapley 值。
特点:1)局部准确性。2)缺失性。3)一致性
模型:1)kernel SHAP 2)Tree SHAP(速度更快)
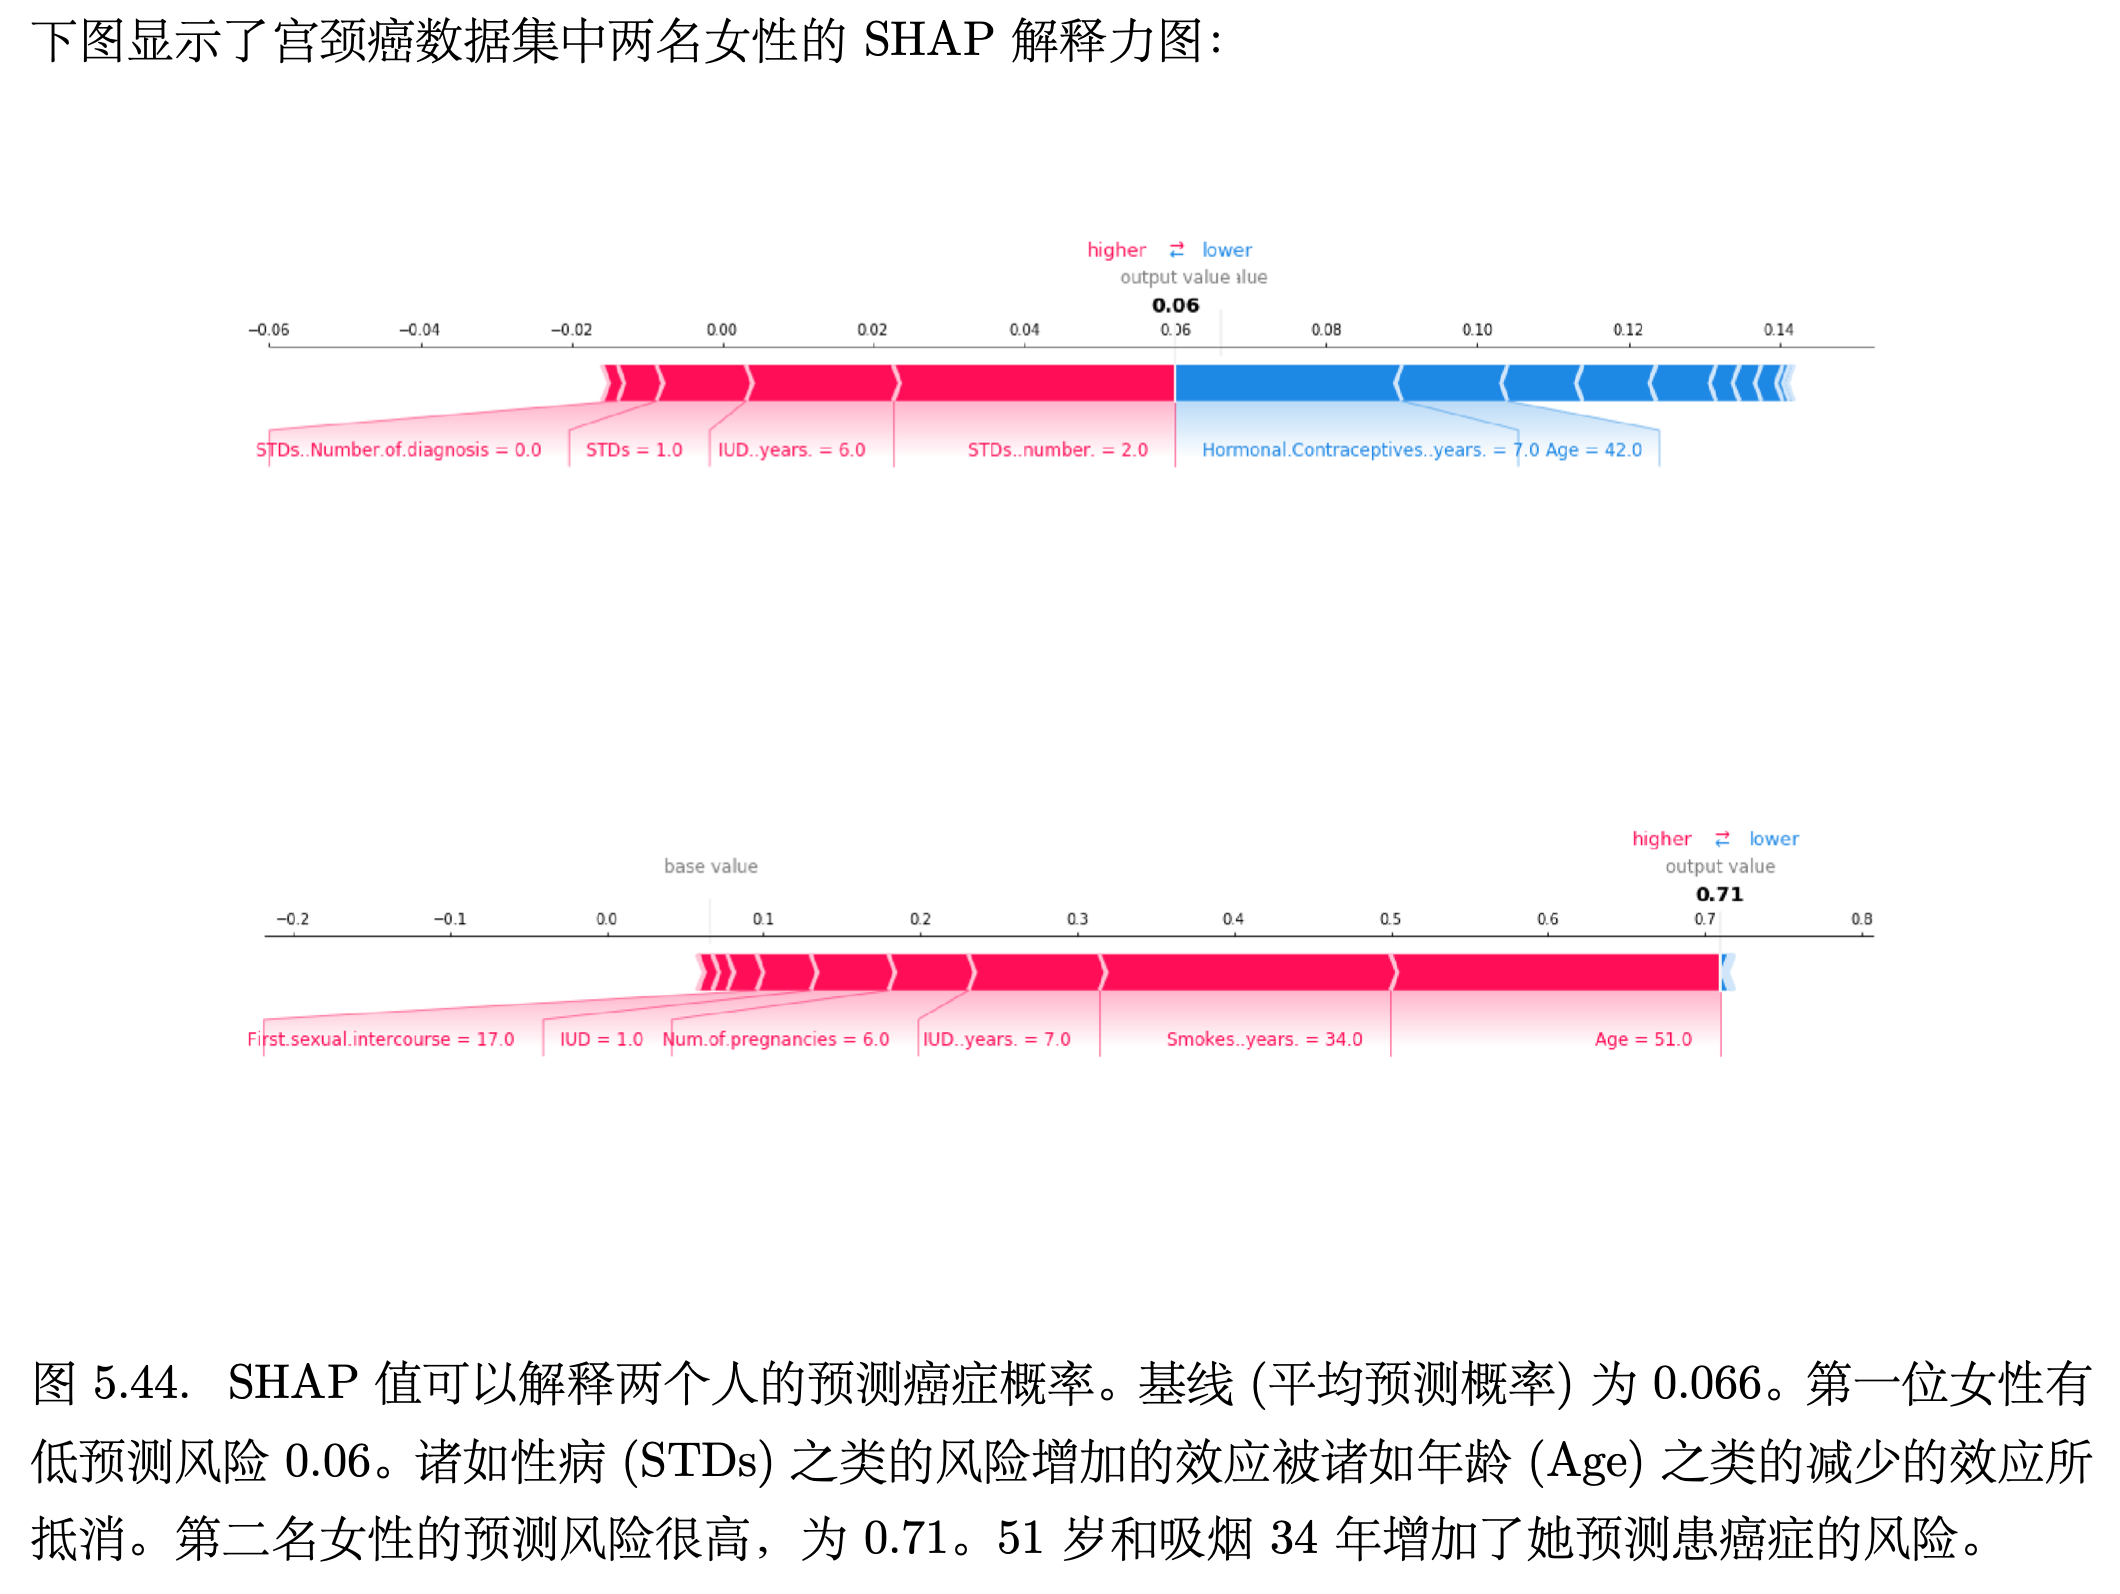
SHAP 特征重要性
SHAP 特征重要性背后的想法很简单:具有较大的 Shapley 绝对值的特征很重要。由于我们需要全 局重要性,因此我们在数据中对每个特征的 Shapley 绝对值取平均值:
接下来,我们通过重要性对特征进行降序排序并绘制它们。下图显示了 SHAP 特征对于预测宫颈癌的经过训练的随机森林的 SHAP 特征重要性。
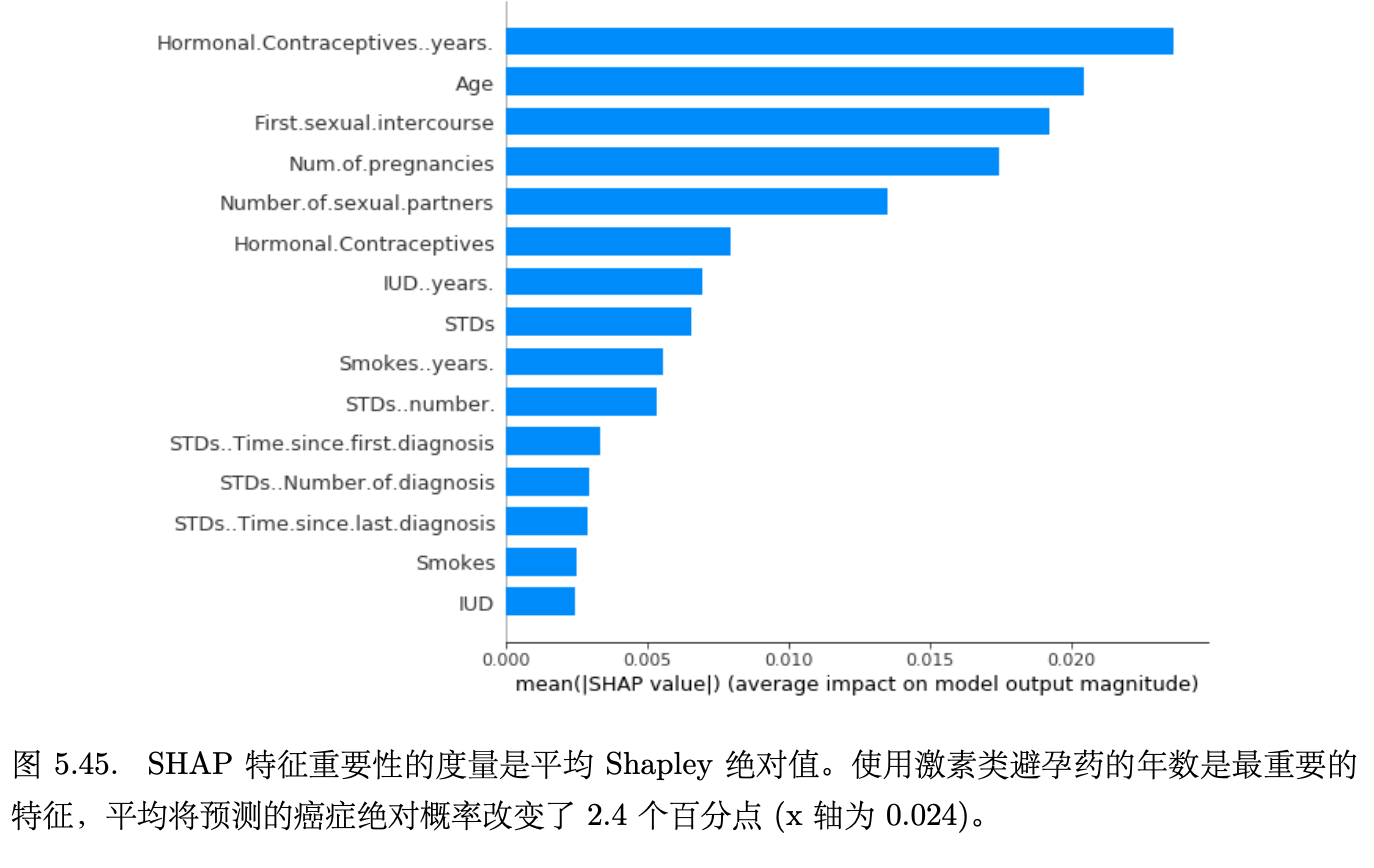
SHAP 特征重要性是置换特征重要性的替代方法。两种重要性度量之间存在很大差异:置换特征重 要性基于模型性能的下降。SHAP 基于特征归因的大小。
优点
由于 SHAP 计算 Shapley 值,因此应用了 Shapley 值的所有优点:SHAP 在博弈论中具有扎实的理论基础。预测结果在特征值中公平分配。我们得到对比性解释,将预测与平均预测进行比较。
SHAP 连接 LIME 和 Shapley 值。这对于更好地了解这两种方法非常有用。它还有助于统一可
解释机器学习的领域。
SHAP 可以快速实现基于树的模型。我认为这是 SHAP 普及的关键,因为采用 Shapley 值的最大 障碍是计算速度慢。
缺点
- Shapley 值的缺点
- KernelSHAP 很慢,一般用tree-shap
软件
作者在 Python SHAP 包中实现了 SHAP。此实现适用于 Python 的 scikit-learn 机器学习库中的 基于树的模型。shap 包也用于本章中的示例。SHAP 已集成到树增强框架 XGBoost 和 LightGBM 中。