最近阅读了Interpretable Machine Learning这本书,将书中内容简单进行了总结,分为上中下三部分笔记,分别是1)可解释的模型 2)模型无关方法的解释 3)基于样本的解释
第一章 前言
可解释性:1.使用可解释的模型 2. 模型无关方法(模型⽆关的解释⽅法将机器学习模型视为⿊盒,即使这些模型本⾝不是⿊盒)
所有与模型⽆关的⽅法 都可以根据它们是在所有数据实例中解释全局模型⾏为还是单个实例预测来进⼀步区分。以下⽅法 解释了模型的整体⾏为:部分依赖图 (Partial Dependence Plots),累积局部效应 (Accumulated Local Effects),特征交互 (Feature Interaction),特征重要性 (Feature Importance),全局代理模型 (Global Surrogate Models) 以及原型和批判 (Prototypes and Criticisms)。为了解释单个实例预测,我们有局部代理模型 (Local Surrogate Models),Shapley 值解释 (Shapley Value Explanations),反事实解释 (Counterfactual Explanations) (密切相关:对抗样本)。可以使⽤⼀些⽅法来解释全局模型⾏为和单个实例预测两个⽅⾯:个体条件期望 (Individual Conditional Expectation) 和有影响⼒的实例 (Influential Instances)。
即使每个模型都可以被解释,但性能最好的模型通常是多个模型的集成,这就变得⽆法解释了。
第二章 可解释性
个人总结:去解释一个模型的时候,最好分为以下几个层面:1)模型的特征重要性。2)全局行为解释:特征概要可视化(比如ALE图去看变量的边际贡献度)。3)单个样本(局部)解释:对单个样本的表现进行评价,某一特征具体取值为最后的预测产生了多大贡献。
一些情况下可能为了可解释性付出预测性能下降的代价。因为需要更多的去了解问题、数据、模型失效的可能原因。机器的决策对人的生活影响越大,机器对它行为的解释就越重要
有些模型可能不需要解释,因为它们是在低风险的环境中使⽤的,这意味着错误不会造成严重后果 (例如,电影推荐系统)
可解释方法分类
本质的 (Intrinsic) 还是事后的 (Post-hoc)?
解释方法的输出:特征概要统计量(例如输出数字为特征重要性)、特征概要可视化(特征的部分依赖图)、模型内部 (例如学习的权重)、数据点(反事实解释,通过⽤⼀些⽅式改变某些特征以改变预测结果)、本质上可解释模型(⽤可解释模型近似黑盒)
可解释性范围
- 算法透明度:算法每一阶段完成什么样的任务
- 全局、整体的模型可解释性:哪些特征很重要,以及它们之间有什么样的交互作⽤?全局的模型可解释性有助于基于特征理解⽬标结果的分布。但在实践中很难实现,5个变量相当于人类理解五维空间的超平面,不现实
- 模块可解释性:特征很多的时候,将哪些特征放在一起看可以有比较高的解释性
- 单个样本预测结果的解释:例如10平房间比100平便宜
好的解释
解释具有对比性:如果输入X的某些变量产生什么样的变化,那么预测就会出现相反的情况(是否同意贷款的解释中可能比较看中这点)⼈类不希望对预测有⼀个完整的解释,⽽是希望将不同之处与 另⼀个实例 (可以是⼈⼯的) 的预测进⾏⽐较。
选择性的解释:解释要简短,即使真实情况很复杂,但只给出 1 到 3 个最主要的原因。 LIME 在这⽅⾯就做得很好。
- 解释的重点是异常:如果样本本身比较罕见,那么这一异常变化可能是导致预测结果不同的原因
- 与先验一致
第四章 可解释的模型
个人总结:- 线性模型的特征重要性统计量、可视化表示、如何解释 这几张图值得实现
- GLM如何选择分布、及其解释方法举例
- 决策树
- IF-THEN:贝叶斯规则列表Bayesian Rule Lists(Letham 等⼈,2015)使⽤贝叶斯统计将预先挖掘的频繁模式组合到决策列表中。使⽤预先挖掘模式是许多规则学习算法所使⽤的常见⽅法。 这个方法值得实现
1. 线性模型
数值特征的解释:当所有其他特征保持不变时,特征 x k 增加⼀个单位,预测结果 y 增加 β k 。
分类特征的解释:当所有其他特征保持不变时,特征 x k 改变为其他类别时,预测结果 y 会增加 β k。
R-square:模型解释了⽬标结果的总⽅差中的多少。R-平⽅越⾼,模型对数据的解释就越好。
- Adjusted R square:R-square随模型中的特征数量的增加⽽增加,即便它们不包含任何关于⽬标值的信息也是如此。因此,最好使⽤调整后的 R-平⽅,它考虑了模型中使⽤的特征数量。
- 特征重要性(之前我仅理解为权重,是不恰当的):$t{\hat{\beta}{j}}=\frac{\hat{\beta}{j}}{S E\left(\hat{\beta}{j}\right)}$ 特征的重要性随着权重的增加⽽增加。估计权重的⽅差越⼤ (= 我们对正 确值的把握越⼩),特征就越不重要。这也是有道理的。
优点:可加性将单个特征的解释与所有其他特征隔离开来。
缺点:这种解释忽略了特征的联合分布。增加⼀个特征,但不改变另⼀个特征,这可能不合 实际或者是不太可能的数据点。例如,如果不增加房屋的⾯积⼤⼩,却增加房间的数量就可能是不 现实的。
可视化解释
- 权重图:
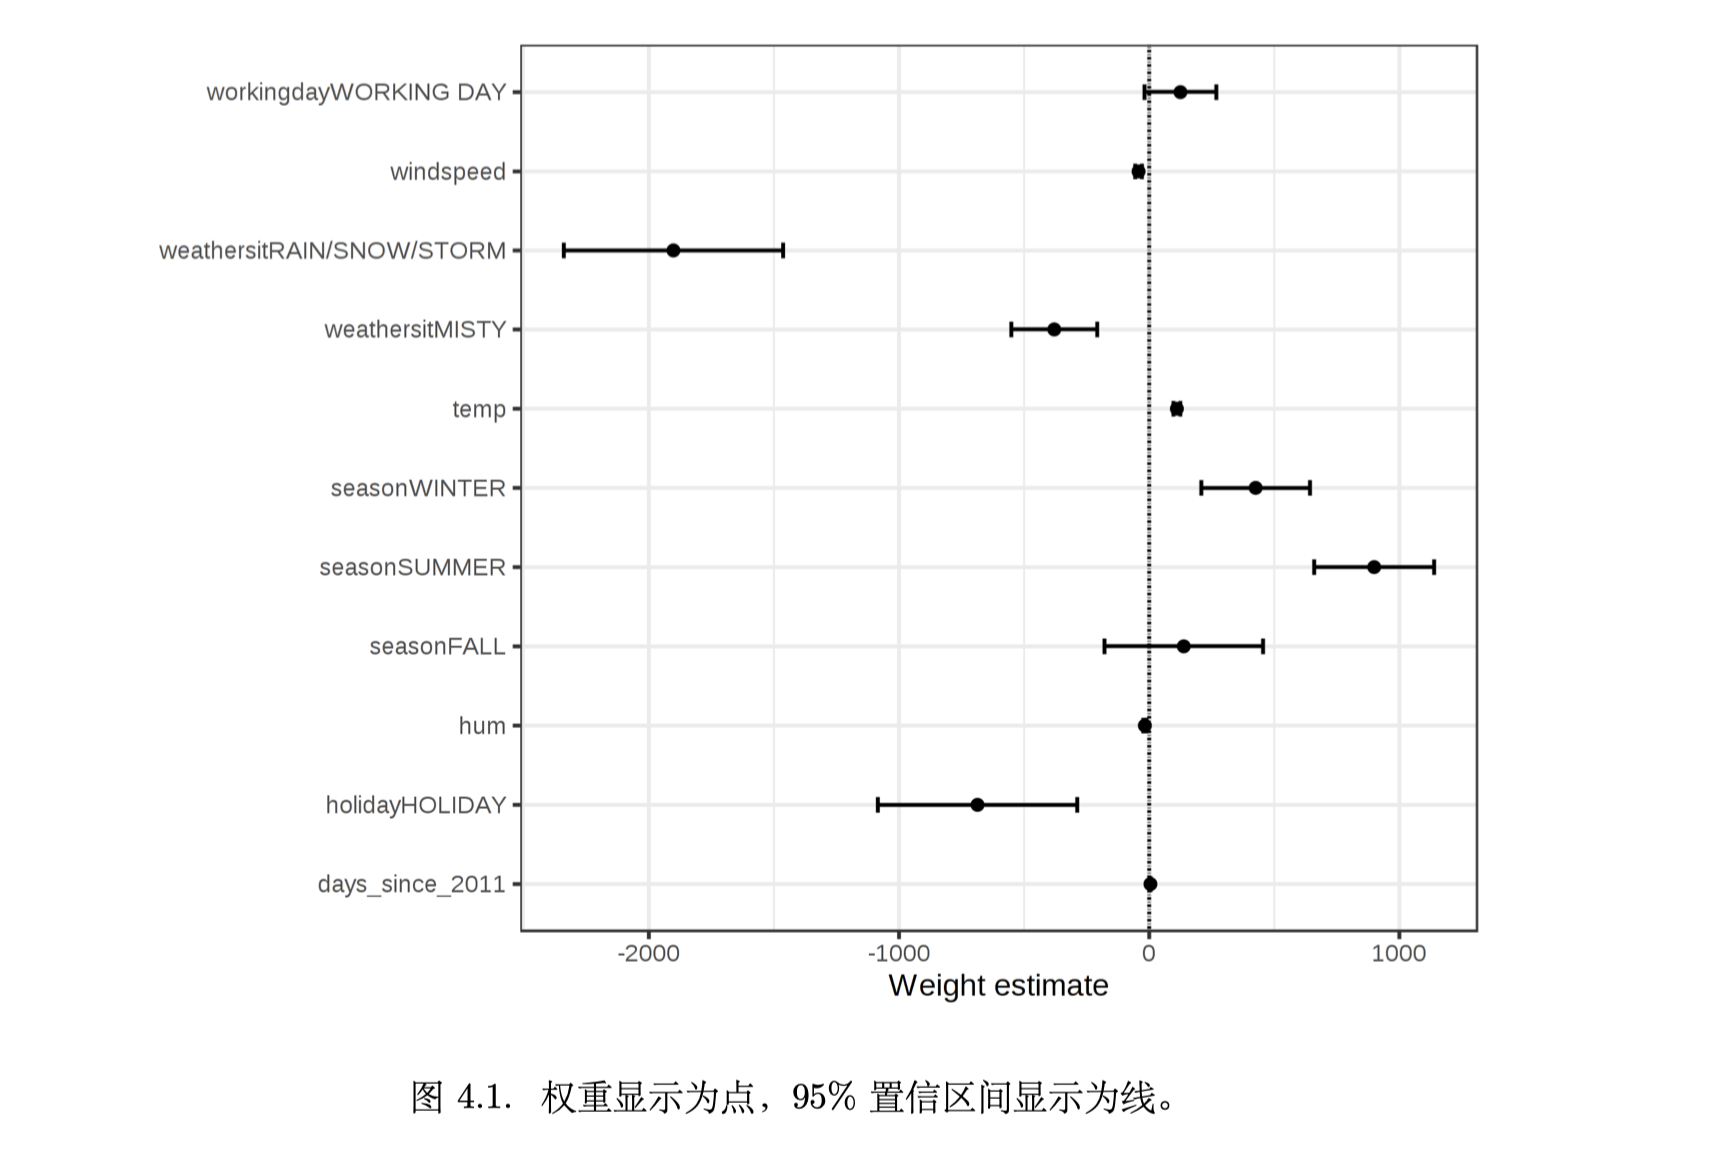
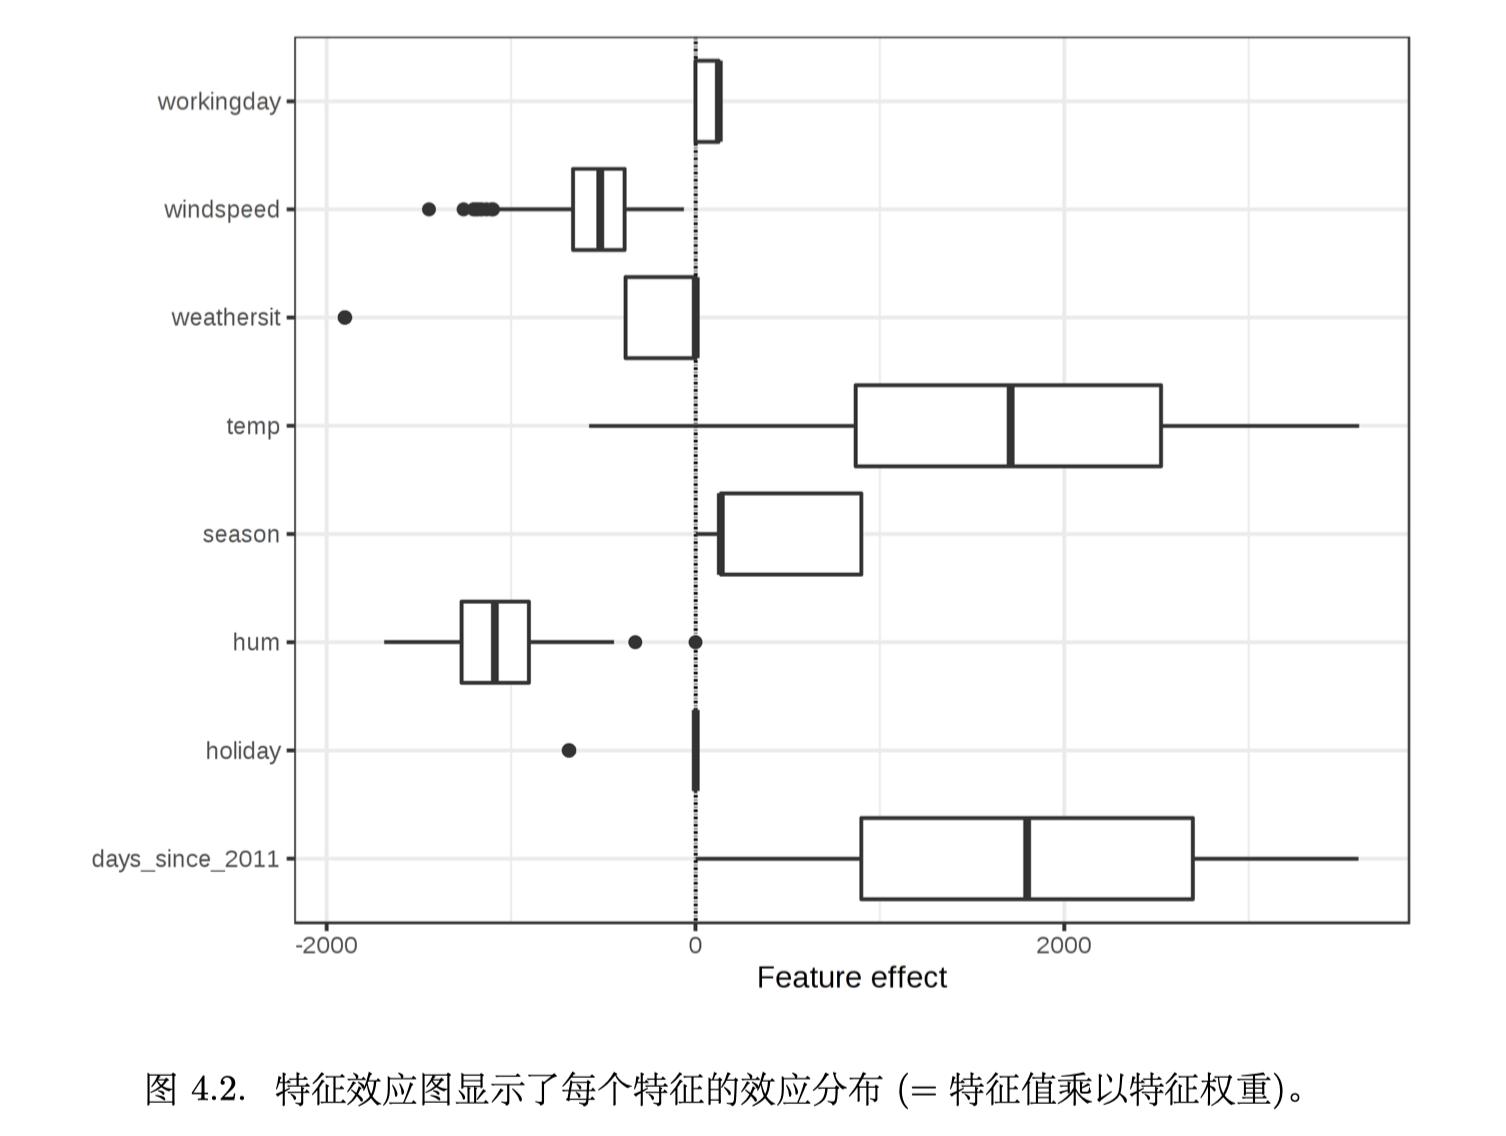
- 效应图(weight乘上下1/4分位数;这个想法很好,不同变量的变化尺度可能差别很大,有些weight大但是本身值很小,所以最终对于解释性的贡献小;例如身高从m变成cm,权重会变大,但其解释性是相同的):比如下图中temp,只看weight很小但是总体而言贡献很大
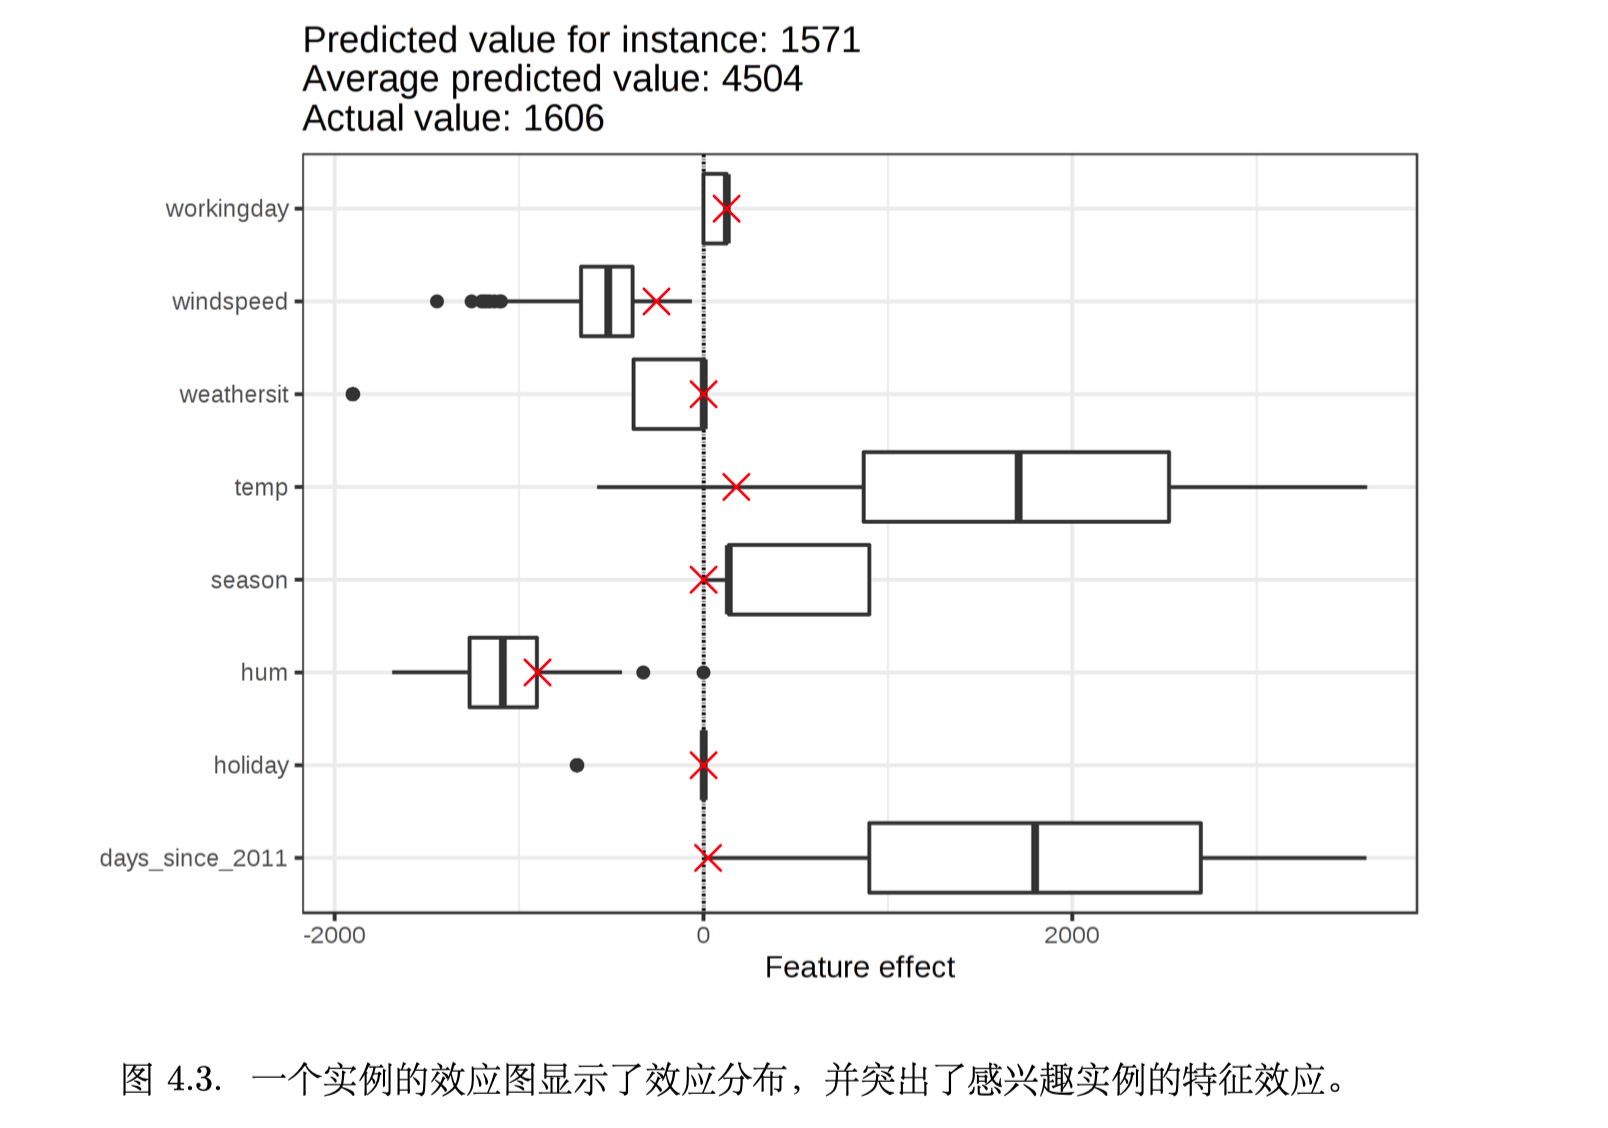
- 单个样本预测结果的解释(放在下图中可以解释为什么红叉样本的预测值低于均值):
稀疏线性模型的解释性
Lasso或者变量选择方法使得线性模型解释性更强,将无关变量筛除
优点:加权和、透明、置信区间,检验和可靠的统计理论
缺点:1. 每一个非线性或交互都必须是人工构成的,并明确地作为输⼊特征提供给模型。2. 从预测性能角度,线性模型通常也不是那么好,⽽且通常过于简单化了复杂的现实。
2. Logitic Regression
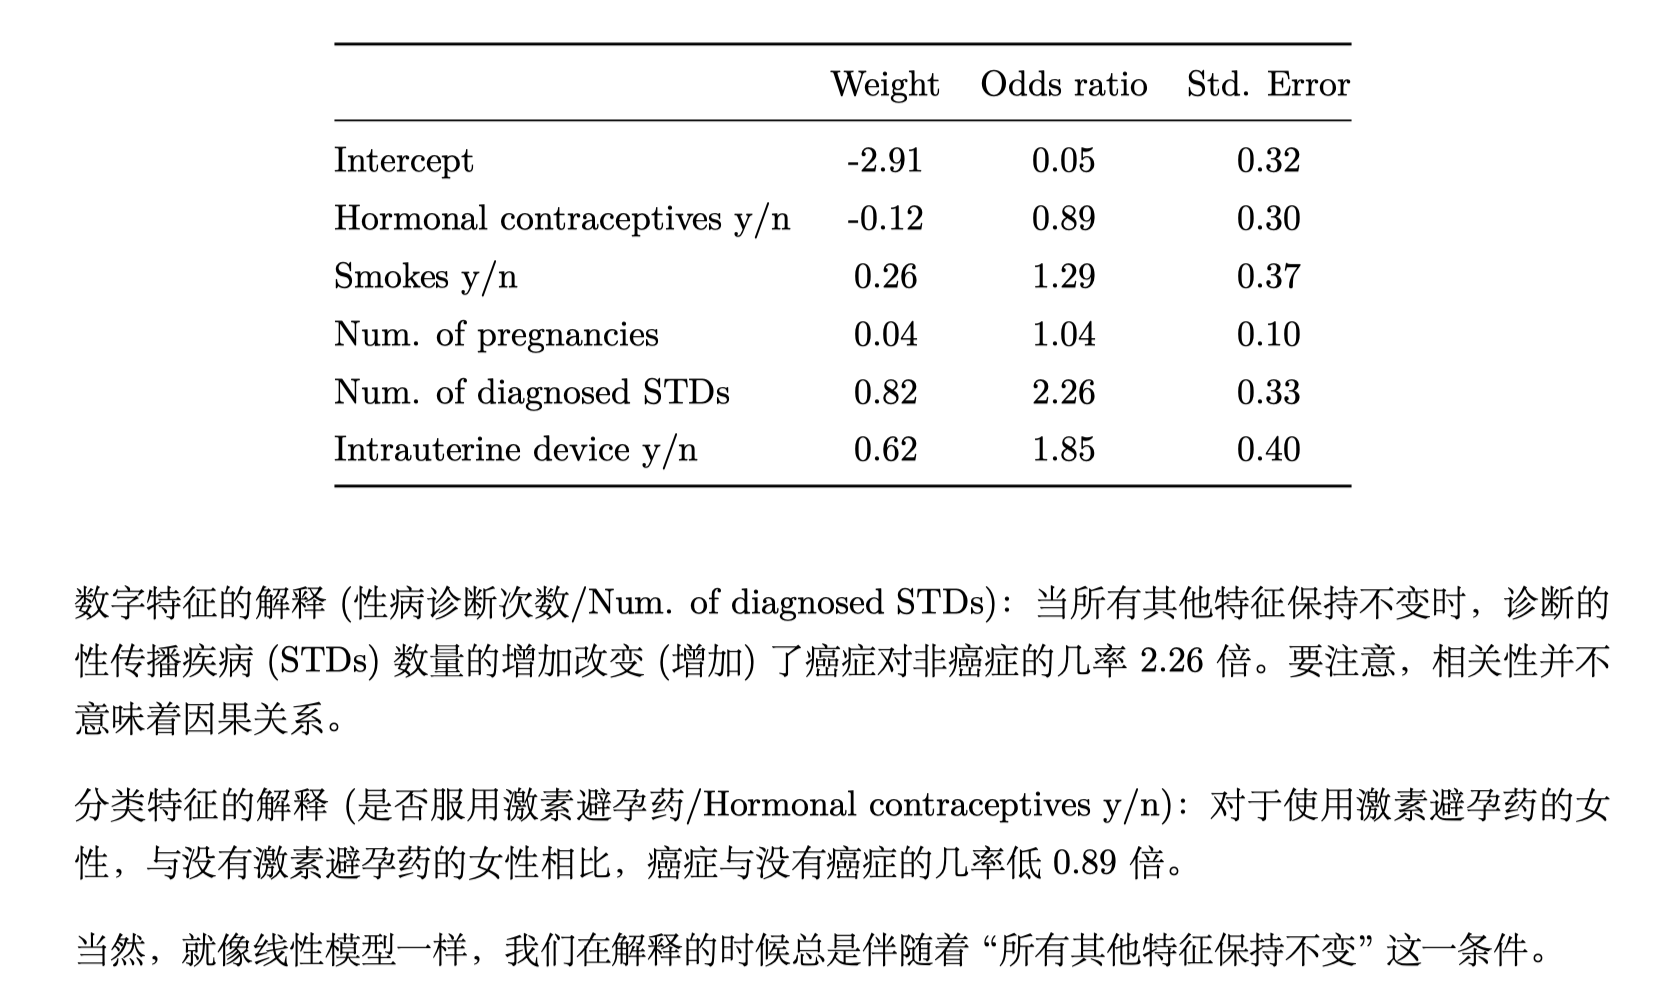
特征重要性(特征权重 exp()如下推导):
所以说 如果你将特征$x_j$增加⼀个单位,则估计的⼏率将乘以因⼦ exp(β j )。比如本身的odds是2,权重$\beta_j=0.7$,若将相应的特征$x_j$增加 1 个单位,⼏率将乘以 exp(0.7) (约 2),也就是⼏率将变为 4。
下图是一个分类模型的解释方法,重要性用的就是exp()
优点:同线性模型、给出的是概率
缺点:解释更困难,因为权重的解释是乘法⽽不是加法。
3. GLM, GAM 和其他模型
GLM例子:$g\left(E{Y}(y | x)\right)=\beta{0}+\beta{1} x{1}+\ldots \beta{p} x{p}$
Poisson回归拟合每天喝咖啡的杯数(Poisson本身就是log()为link function)
由于所有权重都在指数函数中,因此特征影响的解释不是加性的,⽽是乘性的,因为 exp(a + b) = exp(a) exp(b)。压⼒⽔平提⾼⼀点,咖啡的预期数量乘以系数 1.12。将睡眠质量提⾼⼀点,咖啡的预期数量乘以系 数 0.86。⼯作⽇的预测咖啡数量平均是休息⽇咖啡数量的 2.23 倍。总之,压⼒越⼤,睡眠越少,⼯ 作越多,咖啡消耗越多。
非线性效应 - GAM
世界不是线性的。线性模型中的线性意味着,⽆论⼀个实例在某个特定特征中具有什么值,将该值 增加 1 个单位对预测结果总是有相同的效应。温度在 10 摄⽒度时升⾼ 1 度,对租⽤⾃⾏车的数量产⽣的效应是否与温度在 40 摄⽒度时升⾼相同?直观地说,⼈们期望把温度从 10 摄⽒度提⾼到 11 摄⽒度会对⾃⾏车租赁产⽣正效应,从 40 摄⽒度提⾼到 41 摄⽒度会产⽣负效应
对⾮线性关系建模方案:
- 特征的简单转换 (例如对数):使⽤对数表⽰,温度每升⾼ 10 倍,对⾃⾏车数量有相同的线性效应, 因此从 1 摄⽒度到 10 摄⽒度的变化与从 0.1 到 1 的变化具有相同的效果
- 特征分类:离散化特征,将其转化为分类特征。例如,你可以将温度特征 切割为 20 个间隔,级别分别为 [-10, -5),[-5, 0)…等等。只有在有很强理由的情况下,我们才会使⽤离散化。
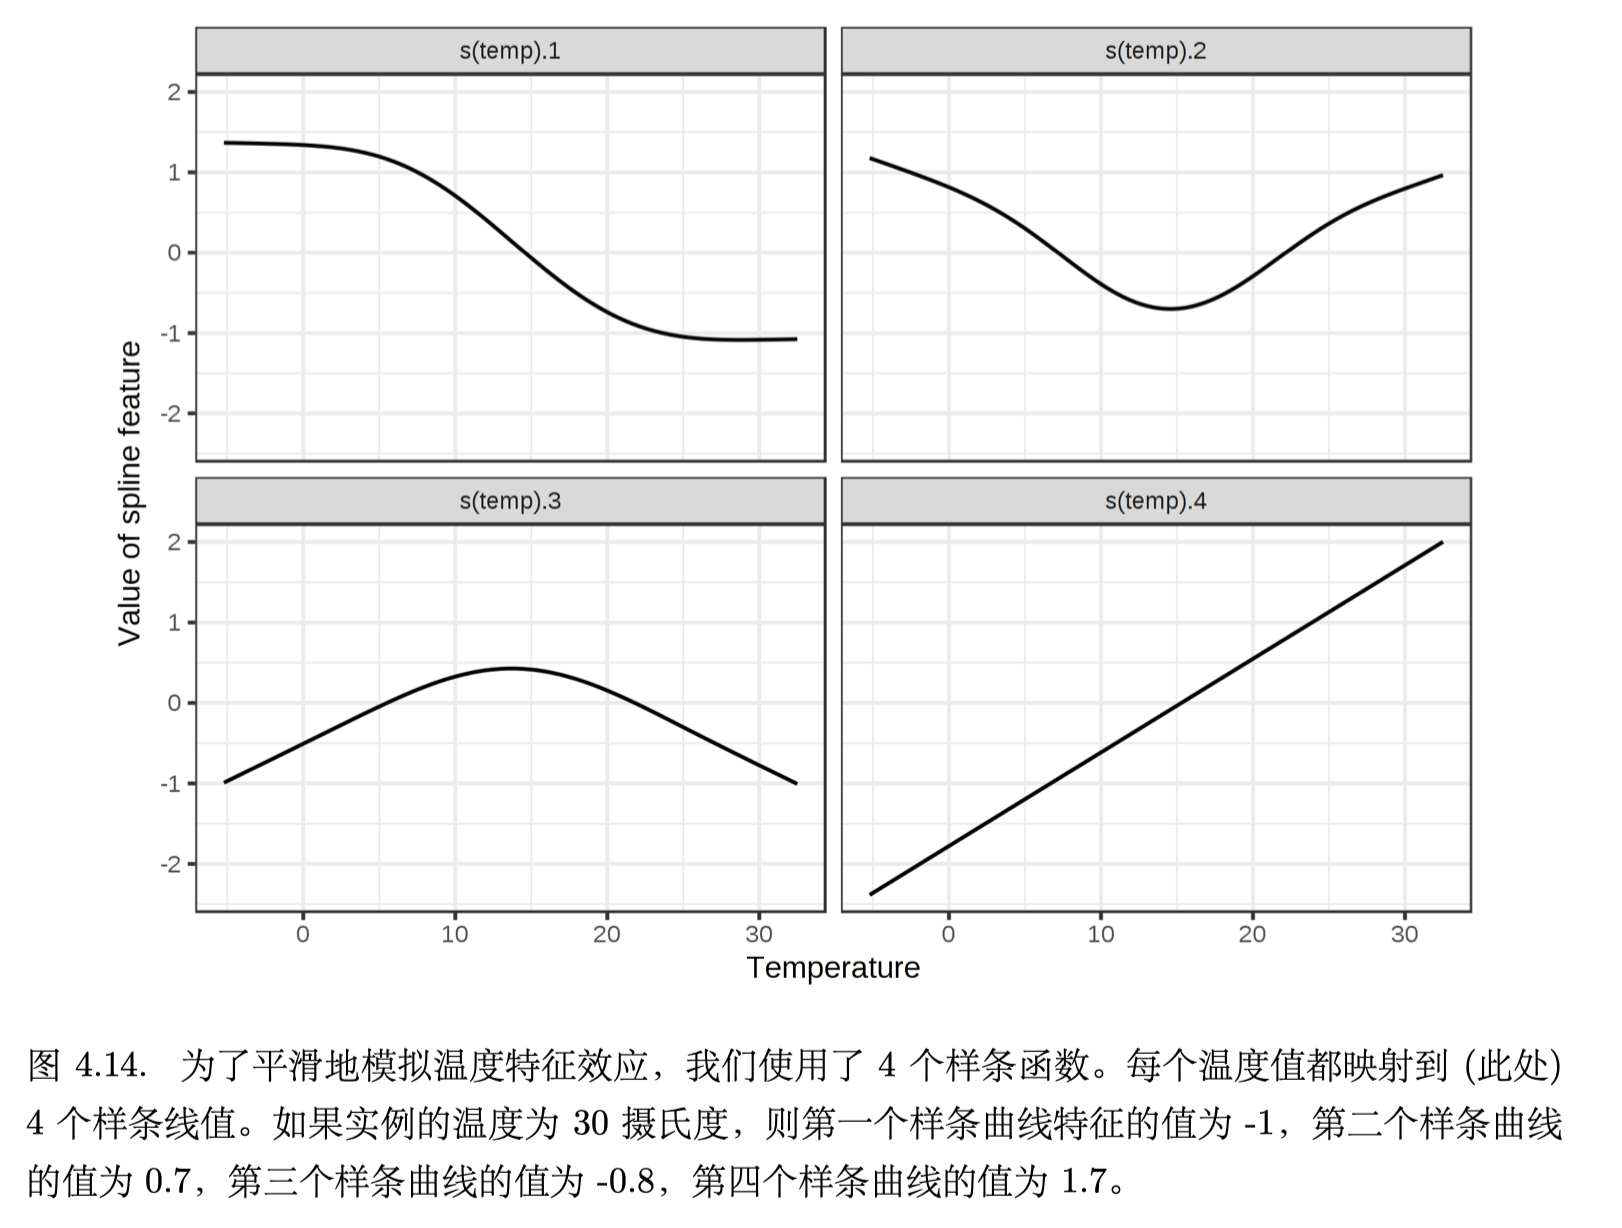
- GAM:该公式与 GLM 公式类似,不同之处在于线性项 β j x j 被更灵活的函数 f j (x j ) 取代。注意,左侧依然是y的条件期望与link function的形式,右侧每个特征$x_j$单独作为一个函数出现。线性效应也包 含在框架中,因为对于要线性处理的特征,我们可以将它们的形式 f j (x j ) 限制为仅采⽤ β j x j 。学习这些非线性函数最好的方法就是spline function。下图就是温度这个变量的四个spline函数
优点:从线性模型平稳过度而来,更加灵活
缺点:线性模型的拓展方法过于多,解释性变差,样条函数难以解释。而且最复杂的线性模型效果大多也不如GBDT和RF这类集成模型
计数问题用Poisson回归比较合适,但如果其中0居多的话,零膨胀泊松回归 (Zero-inflated Poisson Regression), 栅栏模型 (Hurdle Model) 是可能的解决方案
4. 决策树模型
优点:1⾮常适合捕获数据中特征之间的交互。2有自然的可视化解释
缺点:1不能很好处理线性关系,2不够光滑,3不够稳定
5. 规则学习(IF-THEN)
贝叶斯规则列表Bayesian Rule Lists(Letham 等⼈,2015)使⽤贝叶斯统计将预先挖掘的频繁模式组合到决策 列表中。使⽤预先挖掘模式是许多规则学习算法所使⽤的常见⽅法。P79
这个是比较适合实习内容的工作,之后可以深入挖掘一下https://www.cnblogs.com/LittleHann/p/11855323.html
https://github.com/tmadl/sklearn-expertsys
步骤:
- 频繁模式的预先挖掘:类似预处理步骤,使⽤特征 (在此步骤中不需要 ⽬标结果) 并从中提取频繁出现的模式。可以用的算法有Apriori 或 FP-Growth。
- 学习贝叶斯规则列表:通过选择预先挖掘的条件来学习⼀个准确的决策列表。1)⽣成初始决策列表,该列表是从先验分布中随机抽取的。2)通过添加,切换或删除规则来迭代地修改列表,确保结果列表遵循列表的后验分布。3)根据后验分布,从概率最⾼的采样列表中选择决策列表。
优点:易于解释、预测很快很紧凑
缺点:1文献大多研究分类问题,很少用于回归。可行的方法是将连续的特征分割成间隔。2特征通常也是需要分割成间隔,而不是连续的